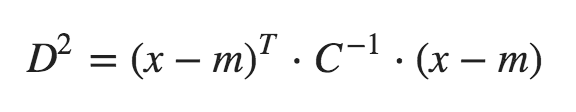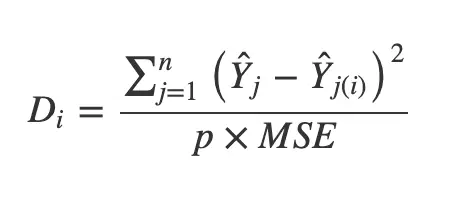Hiển thị các bài đăng có nhãn Dữ liệu. Hiển thị tất cả bài đăng

Chủ Nhật, 30 tháng 11, 2025

Data Capitalism

“Data Capitalism” (chủ nghĩa tư bản dữ liệu) là một khái niệm quan trọng trong kinh tế học số hiện đại, liên quan trực tiếp tới Attention Economy, Platform Economics và Digital Surveillance.

Data Capitalism (chủ nghĩa tư bản dữ liệu) là mô hình kinh tế trong đó dữ liệu cá nhân và hành vi người dùng trở thành yếu tố sản xuất cốt lõi của quá trình tích lũy tư bản. Nếu trong chủ nghĩa tư bản công nghiệp, vốn vật chất (máy móc, lao động) là nguồn lợi nhuận, thì trong chủ nghĩa tư bản dữ liệu, dữ liệu người dùng chính là nguồn tạo ra giá trị và quyền lực kinh tế.


(Nguồn: https://link.springer.com/chapter/10.1007/978-3-030-96180-0_8 )


Bản chất của Data Capitalism

Data Capitalism coi dữ liệu (về sở thích, vị trí, hành vi mua sắm, tương tác xã hội của người dùng) là một loại hàng hóa hoặc tiền tệ có giá trị kinh tế. Mục đích không chỉ là bán sản phẩm hoặc dịch vụ, mà là thu thập dữ liệu hành vi miễn phí (free data) từ trải nghiệm cá nhân của con người để tạo ra các mô hình dự đoán. Việc sử dụng các công nghệ như Big Data (Dữ liệu lớn) và Algorithms (Thuật toán) là cần thiết để phân tích khối lượng dữ liệu khổng lồ này, tạo ra các hồ sơ chi tiết về từng cá nhân, và dự đoán hành vi trong tương lai. 


(Nguồn: https://www.axios.com/2019/06/25/personal-data-big-tech-companies-privacy-capitalism)

Cơ chế hoạt động của Data Capitalism

Ba bước cơ bản:

  1. Thu thập (Extraction)

    • Các nền tảng và thiết bị số thu thập khối lượng lớn dữ liệu hành vi, vị trí, tìm kiếm, thói quen tiêu dùng, tương tác, v.v.

    • Mọi hoạt động số (click, like, watch, swipe) trở thành nguyên liệu thô của sản xuất giá trị.

  2. Phân tích (Processing)

    • Dữ liệu được xử lý bằng big data, machine learning, AI prediction models để tạo ra hồ sơ hành vi (behavioral profiles).

    • Từ đó dự đoán nhu cầu, xu hướng, rủi ro và sở thích của người dùng.

  3. Khai thác giá trị (Monetization)

    • Dữ liệu này được chuyển hóa thành doanh thu quảng cáo, mô hình dự đoán, sản phẩm AI, hoặc lợi thế cạnh tranh.

    • Các công ty sở hữu nền tảng dữ liệu (Google, Meta, Amazon, ByteDance, Microsoft) trở thành các công ty độc quyền/độc quyền nhóm về dữ liệu.


(Nguồn: https://davidbeer.substack.com/p/data-capitalisms-moment)


 Vấn đề đạo đức trong Data Capitalism 

  • Quyền lực và lợi nhuận bị dồn về những tập đoàn sở hữu khả năng tiếp cận và xử lý dữ liệu (các công ty nền tảng), tạo ra sự chênh lệch lớn về quyền lực giữa các công ty và người dân.
  • Quyền riêng tư của người dùng có thể bị vi phạm nặng nề, vai trò của cá nhân bị thu hẹp thành nguồn cung cấp dữ liệu miễn phí, làm xói mòn quyền riêng tư và khả năng kiểm soát cuộc sống cá nhân.
  •  Các công ty sử dụng dữ liệu để dự đoán và kiểm soát hành vi người dùng (ví dụ: hiển thị nội dung, quảng cáo hoặc tin tức để thúc đẩy một hành động cụ thể), ảnh hưởng đến sự tự chủ cá nhân.

Nguồn tham khảo

  • https://towardsdatascience.com/data-capitalism-innovation-extraction-social-conscience-3a30bf2c507b/
  • https://www.researchgate.net/publication/318353271_Data_Capitalism_Redefining_the_Logics_of_Surveillance_and_Privacy
  • https://www.eyemagazine.com/feature/article/ethics-in-the-age-of-data-capitalism
  • https://datacapitalism.d4bl.org/

Chủ Nhật, 5 tháng 10, 2025

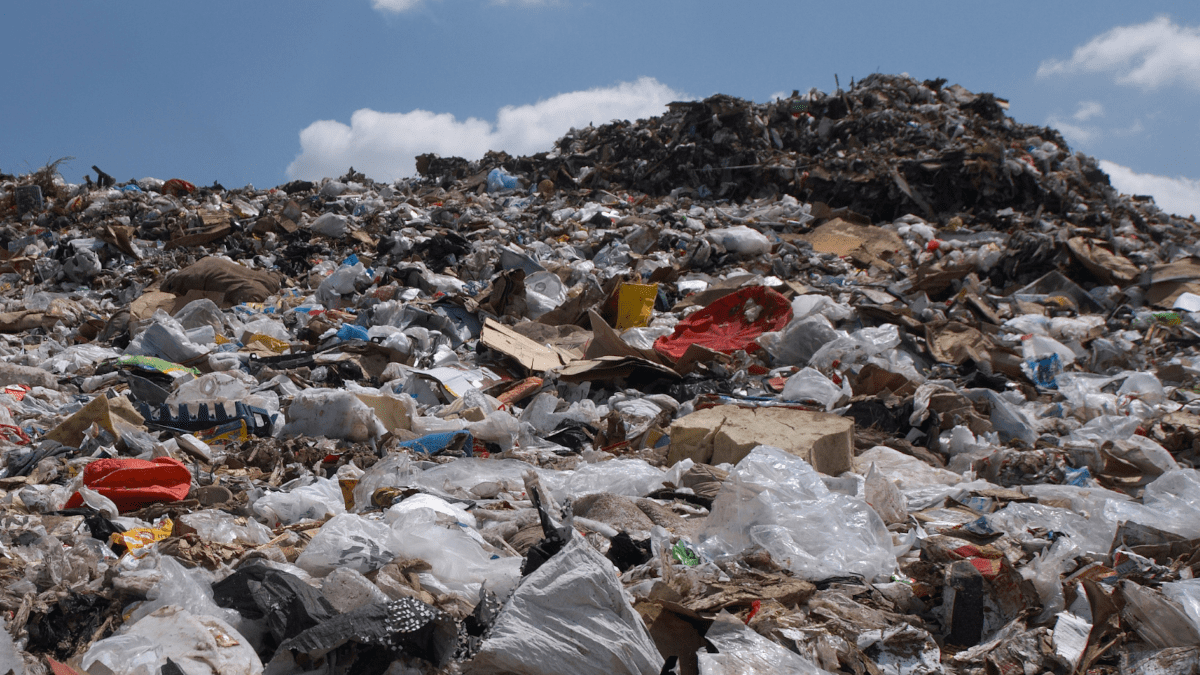
Global Waste Index 2025 (GWI)

Global Waste Index (GWI) là một báo cáo phân tích toàn diện về cách các quốc gia quản lý chất thải, được biên soạn bởi Sensoneo — một công ty công nghệ hàng đầu trong lĩnh vực quản lý chất thải thông minh. GWI so sánh 38 thành viên của Tổ chức Hợp tác và Phát triển Kinh tế (OECD), cung cấp dữ liệu quan trọng để hiểu rõ hiệu quả xử lý chất thải ở các quốc gia phát triển 


(Nguồn: https://envirotecmagazine.com/2022/03/18/global-waste-index-2022-ranking-highlights-leaders-and-laggards/)

Ra mắt lần đầu năm 2019, GWI nêu bật những quốc gia có lượng chất thải cao nhất và phân tích các xu hướng chính trong quản lý chất thải. Phiên bản 2022 cập nhật số liệu mới nhất, phản ánh tác động của đại dịch COVID-19 — đặc biệt là sự gia tăng của rác thải dùng một lần như khẩu trang y tế và bộ xét nghiệm nhanh 


Global Waste Index (GWI) tập trung vào các chỉ số sau:

  • Lượng chất thải sinh hoạt trung bình theo đầu người

  • Tỷ lệ tái chế, đốt (incineration) so với chôn lấp
  • Xử lý chất thải bất hợp pháp (illegal dumping)
  • Tác động môi trường, như khí thải CO₂ và metan từ các bãi chôn lấp, mức độ ô nhiễm do xử lý rác kém.

Một số kết quả đáng chú ý như:

  • GWI 2019 chỉ ra Mỹ là quốc gia tạo nhiều rác sinh hoạt nhất thế giới (812 kg/người/năm).
  • GWI 2022 cho thấy Thổ Nhĩ Kỳ đứng đầu về tác động xấu, do lượng lớn rác bị thải bỏ trái phép; Mỹ tiếp tục là nước phát sinh rác thải sinh hoạt nhiều nhất; Các nước Bắc Âu như Thụy Điển, Na Uy, Phần Lan xử lý rác rất hiệu quả nhờ hệ thống tái chế và đốt rác phát điện.
  • GWI 2025 cho thấy Nhật Bản và Hàn Quốc được đánh giá là những nước quản lý rác thải hiệu quả nhất, nhờ tỷ lệ tái chế cao và hạn chế chôn lấp.

(Nguồn: https://sensoneo.com/global-waste-index/ )


Sensoneo nhấn mạnh rằng GWI chỉ là chỉ số phản ánh sản lượng chất thải — chứ không phản ánh hoàn hảo hệ thống quản lý chất thải của quốc gia. Mục tiêu cuối cùng là giảm thiểu sản sinh rác, và mọi quốc gia vẫn có thể cải thiện hệ thống quản lý chất thải của mình.


Nguồn tham khảo

  • https://sensoneo.com/global-waste-index/
  • https://spnews.com/global-waste-index-2025/

Thứ Sáu, 3 tháng 10, 2025

Yale Environmental Performance Index (EPI)

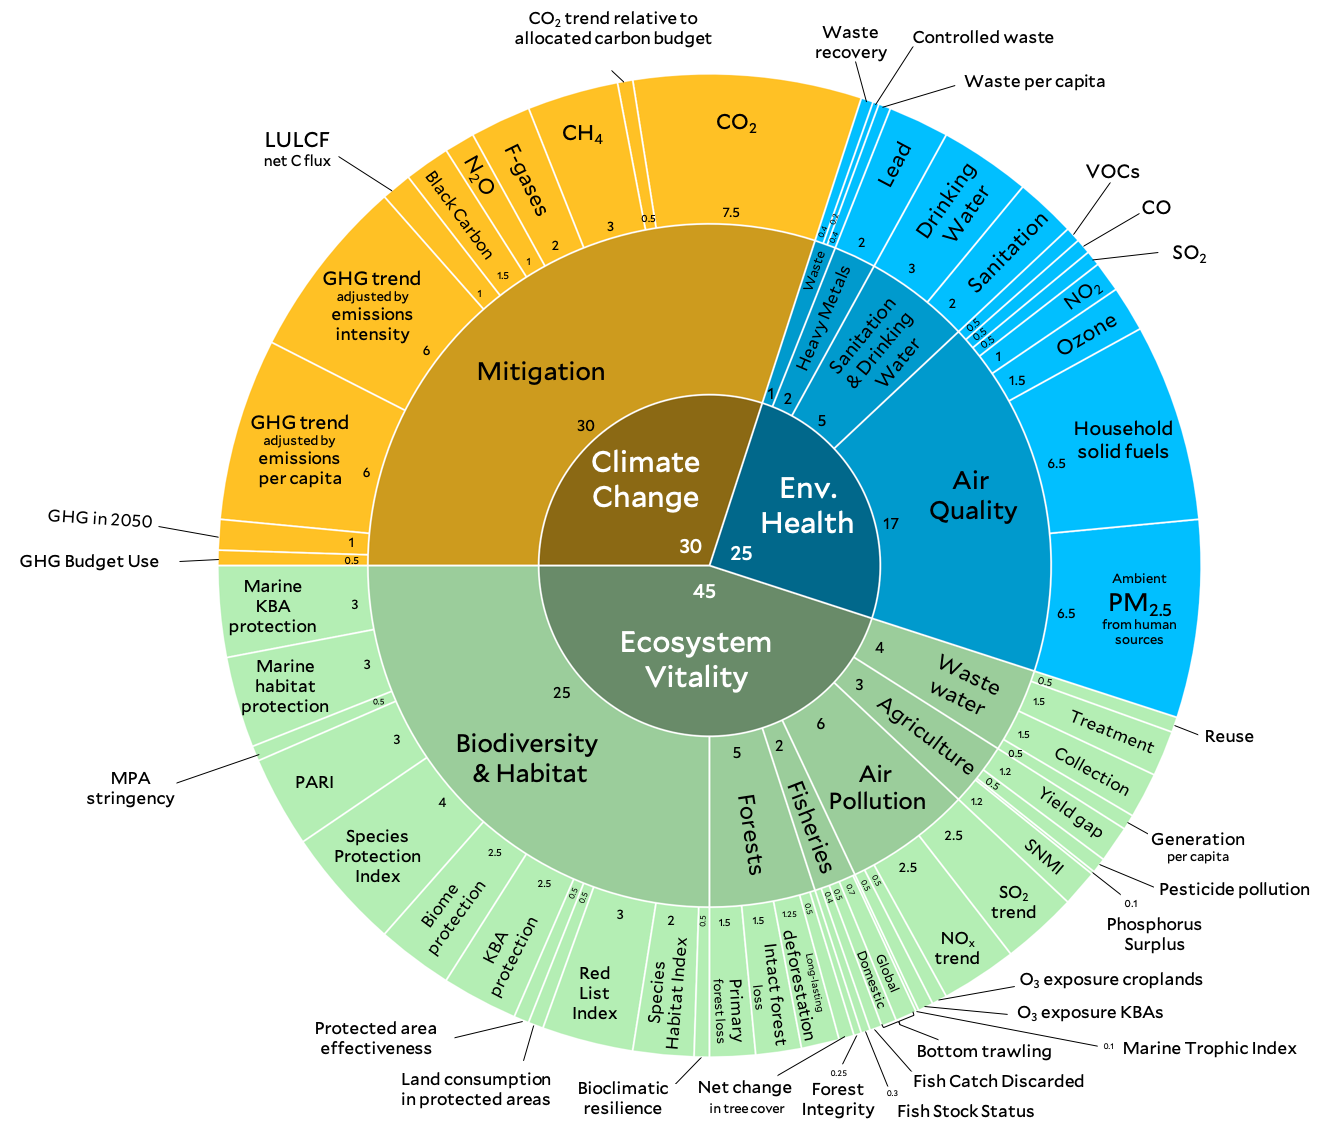
EPI – Environmental Performance Index là một báo cáo định kỳ do Đại học Yale (Mỹ), phối hợp cùng Đại học Columbia và Diễn đàn Kinh tế Thế giới (WEF), công bố. Chỉ số này xếp hạng các quốc gia dựa trên hiệu quả thực thi chính sách môi trường, cung cấp một “tấm gương soi” cho toàn thế giới về mức độ bảo vệ môi trường và phát triển bền vững.


Chỉ số EPI 2022 đánh giá 180 quốc gia dựa trên 40 chỉ số, gói gọn trong 11 lĩnh vực chính thuộc ba nhóm lớn:


  • Sức khỏe môi trường (Environmental Health) – đo lường tác động môi trường tới con người:
    • Chất lượng không khí
    • Vệ sinh, nước sạch
    • Phơi nhiễm kim loại nặng

  • Sức sống hệ sinh thái (Ecosystem Vitality) – phản ánh sức khỏe của hệ sinh thái:
    • Rừng, đa dạng sinh học và môi trường sống
    • Nông nghiệp bền vững
    • Nguồn nước và thủy sản

  • Biến đổi khí hậu (Climate Change) – đánh giá nỗ lực giảm phát thải và ứng phó khí hậu:

    • Lượng phát thải khí nhà kính
    • Năng lượng tái tạo
    • Cam kết Net Zero


(Nguồn: https://epi.yale.edu/ )


Trong bảng xếp hạng EPI năm 2022, Đan Mạch giữ vị trí số 1, dẫn đầu nhờ chính sách khí hậu mạnh mẽ và năng lượng tái tạo. Anh, Phần Lan, Malta, Thụy Điển nằm trong top 5, tất cả đều là các nước châu Âu có chiến lược giảm phát thải rõ ràng. Việt Nam xếp hạng 178/180, chỉ trên Myanmar và Bangladesh.


(Nguồn: https://bluesyemre.wordpress.com/2022/06/15/the-2022-environmental-performance-index/ )


Nguồn tham khảo

  • https://epi.yale.edu/epi-results/2022/component/epi
  • https://ui.adsabs.harvard.edu/abs/2023seda.data..357Y/abstract
  • https://www.earthdata.nasa.gov/es/data/catalog/sedac-ciesin-sedac-epi-2022-2022.00

Thứ Ba, 10 tháng 6, 2025

Bộ chỉ tiêu thống kê phát triển bền vững của Việt Nam

Phát triển bền vững là sự kết hợp và cân bằng ba vấn đề lớn: kinh tế – xã hội và môi trường. Ba vấn đề này đã được giải quyết trong một khung các cam kết có liên quan tới hành động đã được thành lập theo 5 yếu tố: Con người, Hành tinh, Thịnh vượng, Hoà bình và Đối tác với nguyên tắc “không bỏ ai lại phía sau”. Với đĩnh hướng này, bộ chỉ tiêu thống kê phát triển bền vững của Việt Nam là hệ thống gồm 145 chỉ tiêu phản ánh việc thực hiện 17 Mục tiêu Phát triển Bền vững (SDGs) của Liên Hợp Quốc, được Việt Nam nội địa hóa phù hợp với điều kiện quốc gia.


(Nguồn: https://thuvienphapluat.vn/hoi-dap-phap-luat/83A5EBB-hd-da-co-bo-chi-tieu-thong-ke-phat-trien-ben-vung-cua-viet-nam-tu-ngay-1032025.html)


Bộ chỉ tiêu thống kê PTBV của Việt Nam được xem quy định chuẩn mực về chỉ tiêu thống kê, nội dung chỉ tiêu thống kê (gồm khái niệm, phương pháp tính, phân tổ chủ yếu, kỳ công bố, nguồn số liệu, cơ quan chịu trách nhiệm thu thập, tổng hợp) phục vụ cho theo dõi, giám sát, đánh giá thực hiện các mục tiêu PTBV.

Theo Thông tư số 03/2019/TT-BKHĐT của Bộ trưởng Bộ Kế hoạch và Đầu tư, Bộ chỉ tiêu thống kê PTBV của Việt Nam gồm 158 chỉ tiêu, phản ánh 17 mục tiêu chung và 115 mục tiêu cụ thể của Việt Nam quy định tại Quyết định số 622/QĐ-TTg, trong đó:

  • 38 chỉ tiêu thuộc Hệ thống chỉ tiêu thống kê quốc gia ban hành kèm theo Luật Thống kê 2015.

  • 103 chỉ tiêu được phát triển trên các chỉ tiêu PTBV toàn cầu (những chỉ tiêu còn lại không quy định trong Bộ chỉ tiêu thống kê PTBV của Việt Nam do: là chỉ tiêu định tính, chỉ tiêu chỉ tính trên phạm vi toàn cầu và do các tổ chức quốc tế tính, các chỉ tiêu không phù hợp với tình hình kinh tế – xã hội ở Việt Nam, các chỉ tiêu chỉ áp dụng ở các khu vực đặc thù …)

  • 18 chỉ tiêu thống kê có lộ trình B – là những chỉ tiêu sẽ thu thập, tổng hợp từ năm 2025.

Số lượng các chỉ tiêu phân theo 17 mục tiêu chung về PTBV cụ thể như sau:


(Nguồn: https://laodong.vn/thoi-su/phat-trien-ben-vung-va-menh-lenh-cua-thu-tuong-624543.ldo)


Mục tiêu 1: Chấm dứt mọi hình thức nghèo ở mọi nơi: 9 chỉ tiêu;

Mục tiêu 2: Xóa đói, bảo đảm an ninh lương thực, cải thiện dinh dưỡng và thúc đẩy phát triển nông nghiệp bền vững: 7 chỉ tiêu;

Mục tiêu 3: Bảo đảm cuộc sống khỏe mạnh và tăng cường phúc lợi cho mọi người ở mọi lứa tuổi: 20 chỉ tiêu;

Mục tiêu 4: Đảm bảo nền giáo dục có chất lượng, công bằng, toàn diện và thúc đẩy các cơ hội học tập suốt đời cho tất cả mọi người: 14 chỉ tiêu;

Mục tiêu 5: Đạt được bình đẳng về giới, tăng quyền và tạo cơ hội cho phụ nữ và trẻ em gái: 16 chỉ tiêu;

Mục tiêu 6: Đảm bảo đầy đủ và quản lý bền vững tài nguyên nước và hệ thống vệ sinh cho tất cả mọi người: 9 chỉ tiêu;

Mục tiêu 7: Đảm bảo khả năng tiếp cận nguồn năng lượng bền vững, đáng tin cậy và có khả năng chi trả cho tất cả mọi người: 05 chỉ tiêu;

Mục tiêu 8: Đảm bảo tăng trưởng kinh tế bền vững, toàn diện, liên tục; tạo việc làm đầy đủ, năng suất và việc làm tốt cho tất cả mọi người: 17 chỉ tiêu;

Mục tiêu 9: Xây dựng cơ sở hạ tầng có khả năng chống chịu cao, thúc đẩy công nghiệp hóa bao trùm và bền vững, tăng cường đổi mới: 9 chỉ tiêu;

Mục tiêu 10: Giảm bất bình đẳng trong xã hội: 7 chỉ tiêu;

Mục tiêu 11: Phát triển đô thị, nông thôn bền vững, có khả năng chống chịu; đảm bảo môi trường sống và làm việc an toàn; phân bổ hợp lý dân cư và lao động theo vùng: 10 chỉ tiêu;

Mục tiêu 12: Đảm bảo mô hình sản xuất và tiêu dùng bền vững: 9 chỉ tiêu;

Mục tiêu 13: Ứng phó kịp thời, hiệu quả với biến đổi khí hậu và thiên tai: 2 chỉ tiêu;

Mục tiêu 14: Bảo tồn và sử dụng bền vững đại dương, biển và nguồn lợi biển để phát triển bền vững: 7 chỉ tiêu;

Mục tiêu 15: Bảo vệ và phát triển rừng bền vững, bảo tồn đa dạng sinh học, phát triển dịch vụ hệ sinh thái, chống sa mạc hóa, ngăn chặn suy thoái và phục hồi tài nguyên đất: 4 chỉ tiêu;

Mục tiêu 16: Thúc đẩy xã hội hòa bình, công bằng, bình đẳng vì phát triển bền vững, tạo khả năng tiếp cận công lý cho tất cả mọi người; xây dựng các thể chế hiệu quả, có trách nhiệm giải trình và có sự tham gia ở các cấp: 10 chỉ tiêu;

Mục tiêu 17: Tăng cường phương thức thực hiện và thúc đẩy đối tác toàn cầu vì sự phát triển bền vững: 3 chỉ tiêu.


(Nguồn: https://consosukien.vn/thuc-trang-cac-chi-tieu-thong-ke-phat-trien-ben-vung-cua-viet-nam.htm)


Nguồn tham khảo

  • https://thuvienphapluat.vn/van-ban/Bo-may-hanh-chinh/Thong-tu-02-2025-TT-BKHDT-Bo-chi-tieu-thong-ke-phat-trien-ben-vung-cua-Viet-Nam-639033.aspx
  • https://www.gso.gov.vn/tin-tuc-khac/2019/11/tong-quan-chung-ve-bo-chi-tieu-thong-ke-phat-trien-ben-vung-cua-viet-nam/
  • https://thuvienphapluat.vn/hoi-dap-phap-luat/83A5EBB-hd-da-co-bo-chi-tieu-thong-ke-phat-trien-ben-vung-cua-viet-nam-tu-ngay-1032025.html

Thứ Bảy, 8 tháng 2, 2025

Cliometrics

 Cliometrics, còn được gọi là kinh tế lượng lịch sử, là một phương pháp trong nghiên cứu lịch sử kinh tế sử dụng các kỹ thuật định lượng và mô hình kinh tế để phân tích các dữ liệu lịch sử. Thuật ngữ này xuất phát từ Clio, nữ thần lịch sử trong thần thoại Hy Lạp, kết hợp với "metrics" từ tiếng Anh, có nghĩa là đo lường.

Cliometrics phát triển vào giữa thế kỷ 20 và đã cách mạng hóa việc nghiên cứu lịch sử kinh tế, vốn trước đây bị chi phối bởi các phương pháp định tính hơn.


(Nguồn: https://fastercapital.com/topics/introduction-to-cliometrics-and-historical-analysis.html)


Cliometrics được áp dụng nhằm mục đích hiểu rõ các quá trình kinh tế và xã hội trong quá khứ, từ việc xây dựng các mô hình kinh tế để giải thích các xu hướng lịch sử, đến việc sử dụng thống kê và phân tích toán học để kiểm định các giả thuyết lịch sử.

Cliometrics dựa trên bốn trụ cột: mô hình toán học của lý thuyết kinh tế, kinh tế lượng, tập dữ liệu lịch sử kinh tế lớn và công nghệ máy tính để xử lý nhiều phép tính cần thiết.

Nguồn tham khảo:

  • https://www.investopedia.com/terms/c/cliometrics.asp
  • https://fastercapital.com/content/Economic-Modeling--Forecasting-the-Past-with-Cliometrics.html

Thứ Năm, 6 tháng 2, 2025

Worldometers

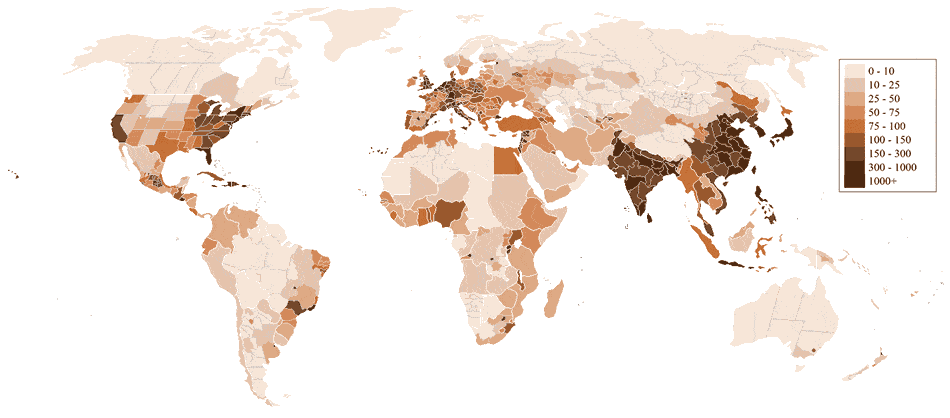
Worldometers là một trang web thống kê trực tuyến cung cấp dữ liệu cập nhật liên tục về một số thông qun quan trọng của các quốc gia. Trang Web này được thành lập và được quản lý bởi một đội ngũ phát triển quốc tế. Số liệu được cung cấp sống động và dễ hiểu. 


(Nguồn:  https://www.worldometers.info/world-population/)


Các thông tin chính trên  Worldometers  gồm có:

  • Kinh tế
  • Dân số
  • Năng lượng
  • Y tế
  • Nước 
  • Nông nghiệp và thực phẩm
Trang Web này có thể truy cập từ địa chỉ: https://www.worldometers.info/

Nguồn tham khảo

  • https://www.worldometers.info/
  • https://tinhte.vn/thread/worldometers-trang-web-thong-ke-dan-so-kinh-te-suc-khoe-toan-the-gioi.3048361/


Thứ Năm, 9 tháng 1, 2025

Air quality index

Chỉ số chất lượng không khí (Air Quality Index - AQI) là một chỉ số được sử dụng để thể hiện mức độ sạch hoặc ô nhiễm của không khí và tác động sức khỏe tiềm ẩn mà không khí ô nhiễm có thể gây ra. 


(Nguồn: https://www.iqair.com/newsroom/iqair-launches-free-media-air-quality-dashboard)

Cách tính toán AQI

Chỉ số AQI được tính toán dựa trên nồng độ của năm chất ô nhiễm không khí chính, mà mỗi loại đều có tác động đến sức khỏe con người. Những chất ô nhiễm này bao gồm:

  • Ozone (O₃) ở tầng đối lưu.
  • Particulate Matter (PM10 và PM2.5) - các hạt vật chất có kích thước nhỏ hơn 10 và 2.5 micromet.
  • Carbon monoxide (CO) - khí CO.
  • Sulfur dioxide (SO₂) - khí SO₂.
  • Nitrogen dioxide (NO₂) - khí NO₂.

Các giá trị nồng độ của từng chất ô nhiễm được chuyển đổi thành một thang điểm từ 0 đến 500. Mức AQI càng cao thì mức độ ô nhiễm càng lớn và những rủi ro tiềm ẩn đối với sức khỏe cũng tăng theo.

Phân loại AQI

AQI được chia thành các khoảng giá trị với các màu sắc tương ứng để dễ dàng nhận biết:

  • 0-50 (Xanh lá): Tốt - Không khí được coi là sạch và chất lượng không khí tốt cho sức khỏe.
  • 51-100 (Vàng): Trung bình - Chất lượng không khí có thể chấp nhận được; tuy nhiên, đối với một số người nhạy cảm với ô nhiễm không khí, có thể có vấn đề sức khỏe nhỏ.
  • 101-150 (Cam): Kém cho nhóm nhạy cảm - Có thể ảnh hưởng xấu đến sức khỏe của nhóm người nhạy cảm.
  • 151-200 (Đỏ): Kém - Mọi người có thể bắt đầu cảm thấy các tác động xấu đến sức khỏe và những người nhạy cảm có thể gặp các vấn đề sức khỏe nghiêm trọng hơn.
  • 201-300 (Tím): Rất kém - Cảnh báo về tình trạng sức khỏe khẩn cấp khi mọi người có thể trải nghiệm các tác động sức khỏe nhiều hơn.
  • 301-500 (Đỏ thẫm): Nguy hiểm - Cảnh báo sức khỏe trong tình trạng khẩn cấp khi toàn bộ dân số có thể bị ảnh hưởng nghiêm trọng.

(Nguồn: https://environmental-initiative.org/wp-content/uploads/2022/05/WordPress_AQI_202222-1110x740.webp)


Nguồn tham khảo

  • https://www.iqair.com/world-air-quality
  • https://environmental-initiative.org/wp-content/uploads/2022/05/WordPress_AQI_202222-1110x740.webp
  • https://blueskyhq.io/blog/what-is-air-quality-index-aqi-and-why-is-it-important


Thứ Ba, 7 tháng 1, 2025

Glex Energy Calculator

"Glex Energy Calculator"  là một công cụ tính toán mô phỏng năng lượng. Glex Energy Calculator" được thiết kế để giúp người dùng khám phá và hiểu rõ hơn về tác động của các lựa chọn năng lượng khác nhau lên môi trường, kinh tế, và khí hậu. 


(Nguồn: https://energy.glex.no/assets/images/GEC-Preview.png)

Glex Energy Calculator hỗ trợ trực quan hóa dữ liệu cho người dùng, trang Web cung cấp các phương thức khác nhau để hiển thị dữ liệu, giúp người dùng dễ dàng nhận thức được tác động môi trường và kinh tế của các lựa chọn năng lượng của họ. Ngoài ra, trang Web còn cho phép người dùng xem các giá trị trung bình được đề xuất trong các báo cáo về biến đổi khí hậu.

Nguồn tham khảo

  • https://energy.glex.no/calculator

Thứ Hai, 26 tháng 8, 2024

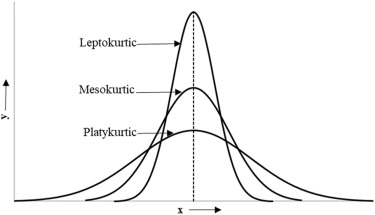
Platykurtic

 "Platykurtic" là một thuật ngữ thống kê dùng để mô tả một phân phối có độ nhọn (kurtosis) thấp hơn so với phân phối chuẩn.


(Nguồn: https://www.isixsigma.com/dictionary/platykurtic-distribution/)

Nguồn tham khảo

  • https://www.investopedia.com/terms/p/platykurtic.asp
  • https://www.6sigma.us/six-sigma-in-focus/platykurtic-distribution/


Thứ Bảy, 27 tháng 7, 2024

Cliometrics

Cliometrics là gì?

Cliometrics - Sử lượng học (tự dịch), còn được biết đến dưới cái tên "new economic history" hoặc "econometric history", là việc sử dụng các kỹ thuật và mô hình kinh tế học định lượng để nghiên cứu và giải thích các sự kiện lịch sử. Tên gọi "cliometrics" được lấy cảm hứng từ Clio - nữ thần lịch sử trong thần thoại Hy Lạp, kết hợp với từ "metrics" thể hiện phương pháp định lượng.

Nhiều cliometricians xác định sự ra đời của lĩnh vực này trong phiên họp chung năm 1957 của Hiệp hội Lịch sử Kinh tế và Hội nghị NBER về "Income and Wealth" được tổ chức tại Williamstown, Massachusetts. Các bài báo được trình bày ở đó đã giới thiệu việc sử dụng các phương pháp được coi là mang tính cách mạng - và sau đó đã trở thành phương pháp thực hành Cliometric. Ba năm sau, vào năm 1960, Lance Davis và J.R.T. Hughes đã tổ chức một hội nghị cho một nhóm nhỏ các học giả tiên phong thực hành những phương pháp mới này. 

(Nguồn: https://media.springernature.com)


Ứng dụng của cliometrics

  • Cliometrics giúp hiểu rõ nguyên nhân và hậu quả của các sự kiện lịch sử, như cuộc Cách mạng Công nghiệp hoặc các cuộc di cư lớn.
  • Nghiên cứu tác động kinh tế của các chính sách, chiến tranh, và các yếu tố khác trong lịch sử.
  • Sử dụng dữ liệu lịch sử để dự báo các xu hướng tương lai và phát triển các chính sách kinh tế hiệu quả hơn.

Mặc dù mang lại nhiều lợi ích, cliometrics không phải không có thách thức. Dữ liệu lịch sử thường không đầy đủ hoặc không chính xác, khiến việc phân tích trở nên phức tạp. Ngoài ra, việc áp dụng các mô hình kinh tế hiện đại cho các sự kiện quá khứ cũng có thể mang lại những hạn chế nhất định về tính chính xác.

Tài liệu tham khảo

  • https://www.investopedia.com/terms/c/cliometrics.asp
  • https://www.cliometrics.org/about/what-is-cliometrics/
  • https://eh.net/encyclopedia/cliometrics/

Thứ Năm, 25 tháng 7, 2024

Bibliometrics

Bibliometrics là gì? 

Bibliometrics là một ngành nằm ở giao điểm của thống kê, toán học và khoa học thông tin, chuyên sử dụng các phương pháp định lượng để phân tích các tài liệu viết; bao gồm các bài báo khoa học, sách, và các dạng văn bản có xuất bản khác. Mục tiêu của bibliometrics là cung cấp cái nhìn sâu sắc về tác động và mức độ lan tỏa của nghiên cứu qua các chỉ số định lượng.


(Nguồn: https://www.linkedin.com/pulse/bibliometric-study-its-type-muhammad-yousuf-ali/)

Các chỉ số phổ biến trong Bibliometrics

  • Số lượng trích dẫn: Đây là số lần các công trình khác trích dẫn đến một bài báo cụ thể. Số lượng trích dẫn càng cao, bài báo đó càng được xem là có ảnh hưởng lớn.
  • H-index: Chỉ số này đo lường cả sản lượng và tác động trích dẫn của các nhà khoa học. Một nhà khoa học có h-index bằng 20 có nghĩa là họ có ít nhất 20 bài báo, mỗi bài được trích dẫn ít nhất 20 lần.
  • Impact Factor: Đây là chỉ số đánh giá tác động trung bình của một tạp chí, tính trên số lượng trích dẫn trung bình cho mỗi bài báo trong một khoảng thời gian nhất định.

(Nguồn: https://s3.amazonaws.com/libapps/accounts/28535/images/Altmetrics.JPG)


Bibliometrics được ứng dụng rộng rãi trong việc xác định xu hướng nghiên cứu, đánh giá chất lượng và tác động của nghiên cứu. Mặc dù mang lại nhiều lợi ích, bibliometrics cũng đối mặt với một số thách thức. Ví dụ, chỉ số trích dẫn không phản ánh chính xác chất lượng thực sự của một nghiên cứu. Một bài báo có thể được trích dẫn nhiều lần do sai sót hoặc tranh cãi, chứ không phải vì nó đóng góp quan trọng cho lĩnh vực. Do đó, việc sử dụng bibliometrics đòi hỏi sự thận trọng và cân nhắc các yếu tố bổ sung.

Tài liệu tham khảo

  • http://tailieudientu.lrc.tnu.edu.vn/Upload/Collection/brief/brief_44653_48651_412201410813939142561PB.pdf
  • https://libguides.baylor.edu/AcademicIdentity/Bibliometrics
  • https://www.sciencedirect.com/science/article/pii/S0148296321003155 

Thứ Năm, 16 tháng 5, 2024

Histograms

Histogram Basics

  • Historams are constructed by binning the data and counting the number of observations in each bin. Common choices for the vertical scale are
    • bin counts, or frequencies
    • counts per unit, or densities
  • The objective is usually to visualize the shape of the distribution.

A HISTOGRAM FOR COUNTING DATA

  • The frequency of any particular x value is the number of times that value occurs in the data set. 
  • The relative frequency of a value is the fraction or proportion of times the value occurs.
  • A frequency distribution is a tabulation of the frequencies and/or relative frequencies.

Drawing histogram for counting data 

  1. First, determine the frequency and relative frequency of each x value. 
  2. Then mark possible x values on a horizontal scale.
  3. Above each value, draw a rectangle whose height is the relative frequency (or alternatively, the frequency) of that value.
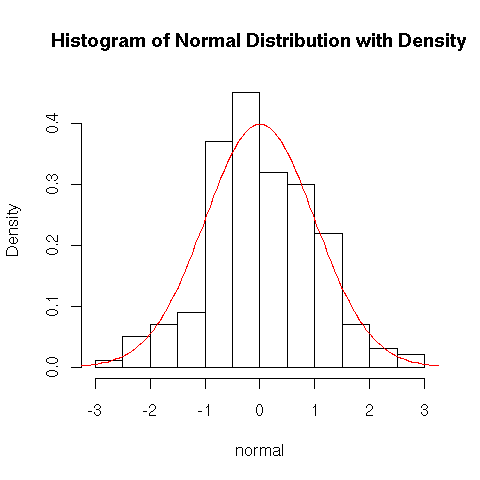
(Nguồn: https://think.design/services/data-visualization-data-design/histogram/)


This construction ensures that the area of each rectangle is proportional to the relative frequency of the value. 

A HISTOGRAM FOR MEASUREMENT DATA: EQUAL CLASS WIDTHS


  • Constructing a histogram for measurement data (observations on a “measurement variable”) entails subdividing the measurement axis into a suitable number of class intervals or classes, such that each observation is contained in exactly one class.
  • One potential difficulty is that occasionally an observation falls on a class boundary and therefore does not lie in exactly one interval. 
  • We can use the convention that any observation falling on a class boundary will be included in the class to the right of the observation.

Drawing histogram for measurement data

  1. Determine the frequency and relative frequency for each class. 
  2. Mark the class boundaries on a horizontal measurement axis. 
  3. Above each class interval, draw a rectangle whose height is the corresponding relative frequency (or frequency).

Note:

  • There are no hard-and-fast rules concerning either the number of classes or the choice of classes themselves
  • A reasonable rule of thumb is that the number of classes can be approximate the square root of the number of observations.
  • Equal-width classes may not be a sensible choice if a data set “stretches out” to one side or the other. 
    • Using a small number of equal-width classes results in almost all observations falling in just one or two of the classes. 
    • If a large number of equal-width classes are used, many classes will have zero frequency.
    • A sound choice is to use a few wider intervals near extreme observations and narrower intervals in the region of high concentration.

A HISTOGRAM FOR MEASUREMENT DATA: UNEQUAL CLASS WIDTHS

  • After determining frequencies and relative frequencies, calculate the height of each rectangle using the formula 
rectangle height = relative frequency of the class : class width
  • The resulting rectangle heights are usually called densities, and the vertical scale is the density scale. This prescription will also work when class widths are equal.
(Nguồn: https://datamining.togaware.com/survivor/Basic_Histogram0.html)


  • When class widths are unequal, not using a density scale will give a picture with distorted areas.
  • A density histogram does have one interesting property: the area of each rectangle is the relative frequency of the corresponding class. Because the sum of relative frequencies must be 1.0 (except for roundoff), the total area of all rectangles in a density histogram is l. 
  • It is always possible to draw a histogram so that the area equals the relative frequency (this is true also for a histogram of counting data)—just use the density scale. 

Histogram Shapes

  • A unimodal histogram is one that rises to a single peak and then declines. 
  • A bimodal histogram has two different peaks.
  • A histogram with more than two peaks is said to be multimodal
  • A histogram is symmetric if the left half is a mirror image of the right half.
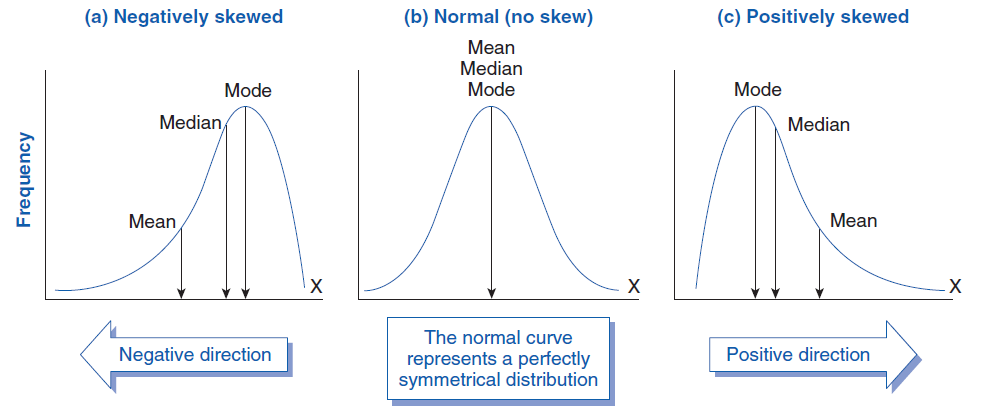
  • A unimodal histogram is positively skewed if the right or upper tail is stretched out compared with the left or lower tail and negatively skewed if the stretching is to the left. 
(Nguồn: https://www.biologyforlife.com/skew.html)

Qualitative Data

  • Both a frequency distribution and a histogram can be constructed when the data set is qualitative (categorical) in nature; in this case, “bar graph” is synonymous with “histogram.” 
  • With such categorical data, the intervals above which rectangles are constructed should have equal width.
Nguồn của thông tin:
  • Devore, J. L., Berk, K. N., & Carlton, M. A. (2012). Modern mathematical statistics with applications (Vol. 285). New York: Springer.


Thứ Ba, 14 tháng 5, 2024

Statistics

 Một số định nghĩa về thống kê

  • Statistics is a branch of applied mathematics that involves the collection, description, analysis, and inference of conclusions from quantitative data. (Investopia)
(Nguồn: https://www.investopedia.com/terms/s/statistics.asp)


  • Statistics is the study of the collection, analysis, interpretation, presentation, and organization of data. In other words, it is a mathematical discipline to collect, summarize data. Also, we can say that statistics is a branch of applied mathematics. (https://byjus.com/maths/statistics/)
  • Statistics has a double meaning. First, Statistics is concerned with scientific methods for collecting, organizing, summarizing, presenting, and analyzing data, as well as drawing valid conclusions and making relevant decisions on the basis of such analysis. In another sense, statistics is used to denote the data themselves. We can speak of economic statistics, geophysical statistics, employment statistics, accident statistics, financial statistics, population statistics, etc. To say that data are statistics, the data sets must be capable of being compared, and must be representative and coherent, and must have been systematically produced so that relevant or significant comparisons or computations can be made. Not all data are statistical data, i.e., able to be analyzed by a statistical method. (https://www.sciencedirect.com/topics/mathematics/statistics)
  • Statistics is also a term that refers to the practice of collecting, analysing, interpreting and communicating data. It is the science of interacting with data. (Australian Bureau of Statistics)
  • Statistics is the science of collecting and analyzing numerical data in large quantities, especially for the purpose of inferring proportions as a whole from those in a representative sample. (https://scse.d.umn.edu/what-math)
(Nguồn: https://qph.cf2.quoracdn.net)


Những kết luận có thể rút ra từ các định nghĩa trên
  • Statistics liên quan đến việc phân tích dữ liệu, bao gồm thu thập, mô tả, tổ chức, tóm tắt và giải thích các thông tin của dữ liệu đó.
  • Statistics được xem là một nhánh của toán học, cụ thể là toán ứng dụng.
  • Statistics dựa trên dữ liệu thực nghiệm, nghĩa là thống kê liên quan đến các quan sát và đo lường trong thế giới thực hơn là các hệ thống lý thuyết.
  • Statistics  thực hiện việc đưa ra các suy luận hoặc kết luận dựa trên phân tích dữ liệu,  diễn giải kết quả để rút ra những thông tin hoặc những hiểu biết có ý nghĩa.
  • Statistics phân tích dữ liệu để có thêm hiểu biết trong tình huống không chắc chắn hoặc có biến động trong dữ liệu. 

Nguồn tham khảo khác
  • https://magazine.amstat.org/blog/2022/10/01/what-is-statistics/
  • https://www.jstor.org/stable/1652319?seq=1

Thứ Bảy, 20 tháng 4, 2024

FACTOR ANALYSIS (Hair, 2013)

  • Factor analysis is an interdependence technique whose primary purpose is to define the underlying structure among the variables in the analysis. 
  • Broadly speaking, factor analysis provides the tools for analyzing the structure of the interrelationships (correlations) among a large number of variables (e.g., test scores, test items, questionnaire responses) by defining sets of variables that are highly interrelated, known as factors. 
  • Factor analytic techniques can achieve their purposes from either an exploratory or confirmatory perspective. 
FACTOR ANALYSIS DECISION PROCESS


(Nguồn: Hair, 2009)


(Nguồn: Hair, 2009)


Factor analysis provides the researcher with two distinct, but interrelated, outcomes: data summarization and data reduction. 
  • In summarizing the data, factor analysis derives underlying dimensions that, when interpreted and understood, describe the data in a much smaller number of concepts than the original individual variables. 
  • Data reduction extends this process by deriving an empirical value (factor score) for each dimension (factor) and then substituting this value for the original values.
DATA SUMMARIZATION
    • The fundamental concept involved in data summarization is the definition of structure. Through structure, the researcher can view the set of variables at various levels of generalization, ranging from the most detailed level (individual variables themselves) to the more generalized level, where individual variables are grouped and then viewed not for what they represent individually, but for what they represent collectively in expressing a concept.
    • The goal of data summarization is achieved by defining a small number of factors that adequately represent the original set of variables
    • Structure is defined by the interrelatedness among variables allowing for the specification of a smaller number of dimensions (factors) representing the original set of variables. 
      DATA REDUCTION
      • Factor analysis can also be used to achieve data reduction by 
        • (1) identifying representative variables from a much larger set of variables for use in subsequent multivariate analyses, 
        • or (2) creating an entirely new set of variables, much smaller in number, to partially or completely replace the original set of variables. 
      • In both instances, the purpose is to retain the nature and character of the original variables, but reduce their number to simplify the subsequent multivariate analysis. 
      Data summarization makes the identification of the underlying dimensions or factors ends in themselves. Thus, estimates of the factors and the contributions of each variable to the factors (termed loadings) are all that is required for the analysis. 

      Data reduction relies on the factor loadings as well, but uses them as the basis for either identifying variables for subsequent analysis with other techniques or making estimates of the factors themselves (factor scores or summated scales), which then replace the original variables in subsequent analyses. 

      Nguồn: 
      • Hair, J. F. (2009). Multivariate data analysis.

      Thứ Năm, 18 tháng 4, 2024

      Managing the Variate


      Specifying the Variate Variables

      • To decide whether to use the individual variables or to perform some form of dimensional reduction, such as exploratory factor analysis. 
      Variable Selection
      • To make regarding the variate is if the researcher wants to control the specific variables to be included in the analysis or let the software determine the “best” set of variables to constitute the variate.


      Nguồn: 
      • Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Boston: Cengage.


      Thứ Hai, 15 tháng 4, 2024

      Outliers in Regression

       Trong hồi quy có thể kể đến 3 dạng quan sát bất thường:

      • Regression Outliers
      • Leverage 
      • Influential Observations

      Regression Outliers

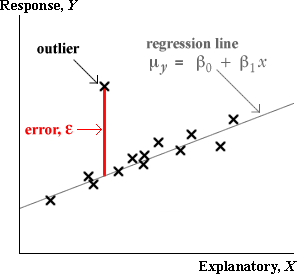
      Quan sát ngoại lệ trong hồi quy là một quan sát có giá trị bất thường của biến phụ thuộc Y khi sánh với các trường hợp khác có cùng giá trị của các biến độc lập X


      (Nguồn: https://static.wixstatic.com/media/9a9006_296dff8aa18840bebbd563ef81eee666~mv2.gif)


      Leverage 

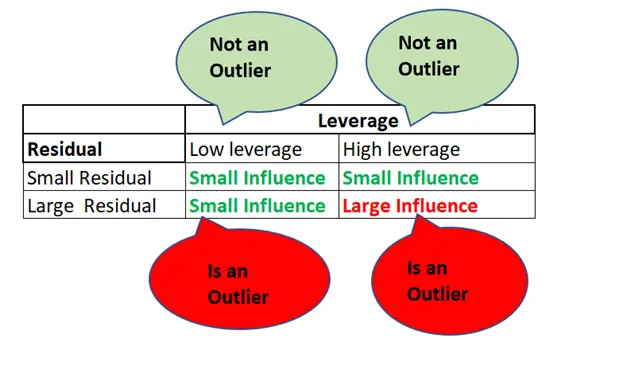
      • Các giá trị bất thường khi xem xét chỉ với các biến độc lập thì được gọi là điểm đòn bẩy. Một quan sát có giá trị X bất thường - tức là nó khác xa với giá trị trung bình của X - tức là có khả năng tiềm ẩn làm ảnh hưởng đến kết quả hồi quy. Tuy nhiên, giá trị đòn bẩy của một quan sát cao thì không nhất thiết có nghĩa là quan sát đó có ảnh hưởng đến hệ số hồi quy.

      (Nguồn: https://www.researchgate.net/publication/265097085_Do_theme_parks_deserve_their_success)


      Influential Observations

      Những quan sát có giá trị đòn bẩy cao và thực sự có ảnh hưởng đến hệ số góc của các biến độc lập trong kết quả hồi quy thì được gọi là điểm ảnh hưởng (Influential observations). Nghĩa là, chỉ khi một quan sát có đòn bẩy cao và là một ngoại lệ về mặt giá trị xét theo biến phụ thuộc Y thì nó mới ảnh hưởng mạnh mẽ đến đường hồi quy. Nói cách khác, một influential observation  phải có giá trị Xbất thường với giá trị Y bất thường tương ứng với giá trịX của nó. Trong những trường hợp như vậy, cả hệ số chặn và hệ số góc đều bị ảnh hưởng khi sử dụng quan sát này trong dữ liệu.


      (Nguồn: https://pub.towardsai.net/the-outlier-story-leverage-and-influential-point-in-linear-regression-31517f2ca203)

      Nguồn tham khảo:
      •  https://ouzhang.me/blog/outlier-series/outliers-part3/
      • https://pub.towardsai.net/the-outlier-story-leverage-and-influential-point-in-linear-regression-31517f2ca203
      • https://www.solutions4statistics.com/post/2017/07/27/detect-remove-outliers-in-regression

      Thứ Bảy, 13 tháng 4, 2024

      Mahalanobis Distance

      Mahalanobis distance được đặt theo tên nhà thống kê Ấn Độ Prasanta Chandra Mahalanobis. Ông đóng vai trò then chốt trong việc thành lập Viện Thống kê Ấn Độ (ISI) và đóng góp đáng kể vào sự phát triển các phương pháp thống kê ở Ấn Độ. Mahalanobis nhận ra những hạn chế của việc sử dụng khoảng cách Euclide để phân tích dữ liệu đa biến, đặc biệt khi xử lý các biến tương quan. Để giải quyết vấn đề này, ông đã đề xuất một thước đo khoảng cách kết hợp cấu trúc hiệp phương sai của dữ liệu vào năm 1930 và sau đó, thước đo này được đặt tên ông. Khoảng cách Mahalanobis đã trở thành một trong những đóng góp lâu dài nhất của ông cho ngành thống kê.

      Khoảng cách Mahalanobis dùng để xác định mức độ khác biệt (dissimilarity) giữa hai điểm dữ liệu trong không gian đa chiều và có tính đến cấu trúc hiệp phương sai của dữ liệu. 

      Công thức tính khoảng cách Mahalanobis

      Trong đó:

      •  D2 là bình phương khoảng cách Mahalanobis.
      •  x là vectơ giá rrị cụ thể của các quan sát (các dòng trong tập dữ liệu),
      •   m là vectơ giá trị trung bình của các biến độc lập (trung bình mỗi cột),
      • C^(-1) là ma trận hiệp phương sai nghịch đảo của các biến độc lập.


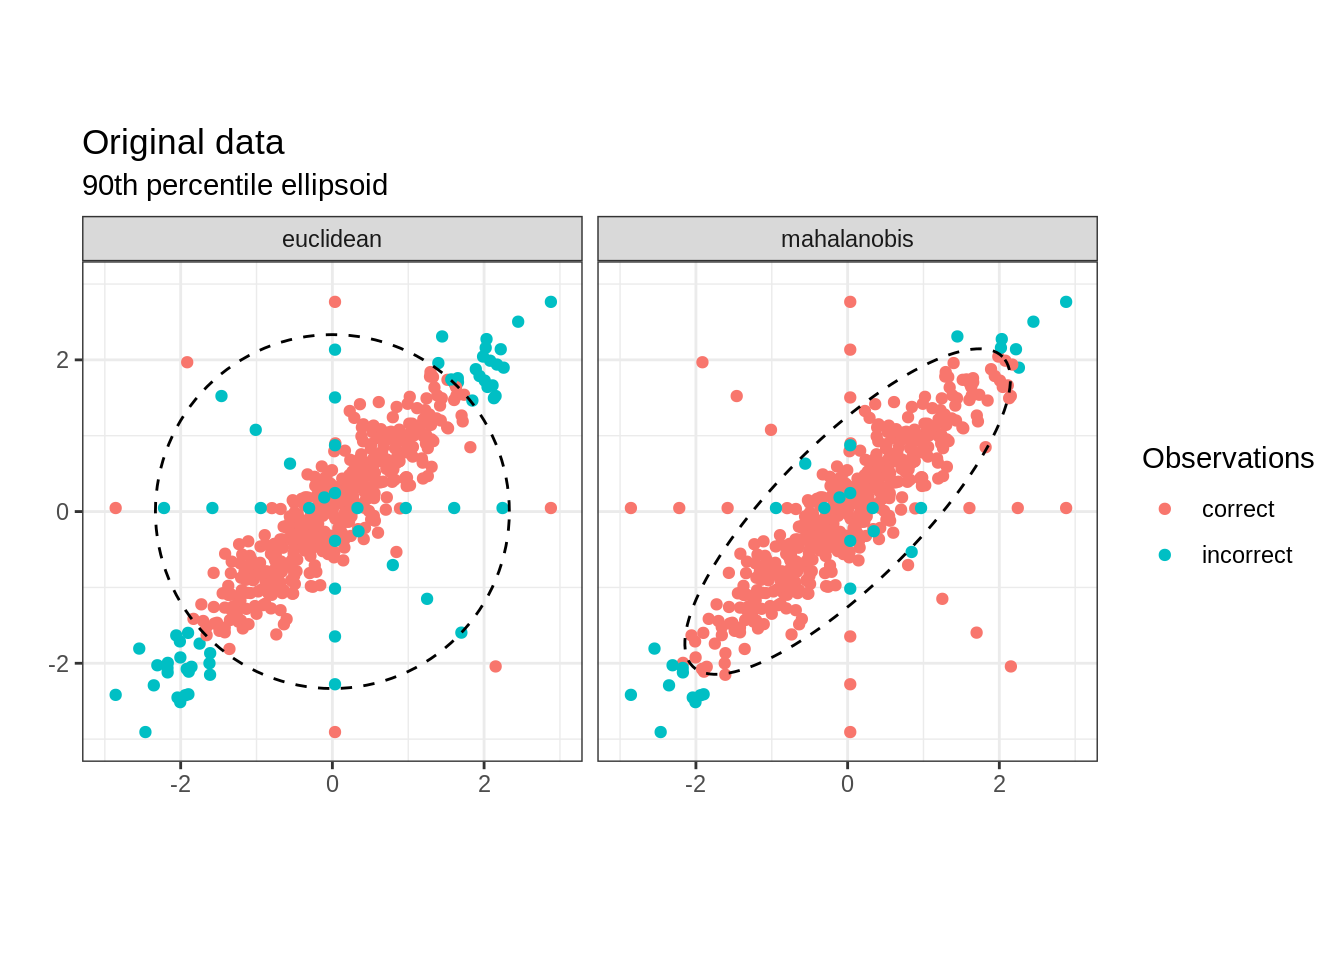
      Khoảng cách Mahalanobis khác với khoảng cách Euclide như thế nào?

      • Khoảng cách Mahalanobis thực hiện biến đổi các biến thành các biến không tương quan trước khi tính toán
      • Chuẩn hóa để làm cho phương sai của các biến bằng 1
      • Cuối cùng, tính toán khoảng cách Euclide giữa các biến sau khi chuẩn hóa
      (Nguồn: https://www.charlesgauvin.ca/post/distances-and-outlier-detection/)


      Nguồn tham khảo:
      • https://www.charlesgauvin.ca/post/distances-and-outlier-detection/
      • https://ouzhang.me/blog/outlier-series/outliers-part4/#model-specific-methods
      • https://core.ac.uk/download/pdf/233075917.pdf

      Thứ Năm, 11 tháng 4, 2024

      Cook’s Distance

      Cook’s distance được đặt theo tên của nhà thống kê người Mỹ R. Dennis Cook, người đầu tiên đã đưa ra khái niệm này vào năm 1977.
      • Khoảng cách Cook (Cook’s distance hay Cook’s D) là đại lượng thường được sử dụng để đánh giá ảnh hưởng của một điểm dữ liệu (một quan sát - observation) khi thực hiện phân tích hồi quy bình phương tối thiểu. Cook’s distance rất hữu ích trong việc xác định các giá trị ngoại lệ trong các giá trị biến độc lập. Nó cũng cho thấy ảnh hưởng của từng quan sát đến kết quả ước lượng biến phụ thuộc.


      • (Case Deletion Diagnostics) Nếu kết quả dự báo biến phụ thuộc là giống nhau dù có hoặc không có quan sát được xem xét thì quan sát đó không có ảnh hưởng đến mô hình hồi quy. Nếu các dự đoán khác nhau nhiều khi quan sát không được đưa vào phân tích thì quan sát là quan sát có ảnh hưởng.

      • Dựa trên ý tưởng này, khoảng cách Cook đo lường tác động của việc xóa một quan sát nhất định. Khoảng cách Cook của từng quan sát được tính toán bằng sự mức chênh lệch được chuẩn hóa (normalized) của vector hệ số hồi quy khi có và không có quan sát đang xem xét. 
      • Trong phân tích bình phương tối thiểu thông thường, khoảng cách Cook có thể được sử dụng theo nhiều cách: để chỉ ra các điểm dữ liệu đặc biệt cần thiết phải kiểm tra tính hợp lệ; hoặc để chỉ ra các vùng của tổng thể mà cần bổ sung quan sát đại diện trong mẫu.

      Cook’s Distance Formula


          Trong đó:

      • Ŷj  : giá trị ước lượng biến phụ thuộc khi tất cả các quan sát được sử dụng, kể cả quan sát cần kiểm tra.
      • Ŷ j(i) : là giá trị ước lượng biến phụ thuộc khi không có quan sát thứ i
      • MSE: mean squared error.
      • p là số tham số trong mô hình hồi quy
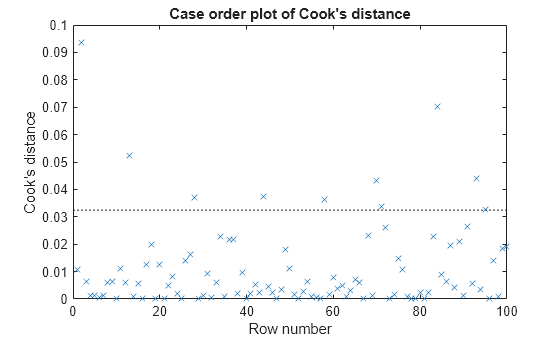
      Kết quả tính toán khoảng cách Cook của một bộ dữ liệu có thể được biểu diễn bằng đồ thị

      (Nguồn: https://help.displayr.com/hc/article_attachments/4402082016143)

      (Nguồn: https://www.mathworks.com/help/stats/cooks-distance.html)


      Nguồn tham khảo

      • https://www.statisticshowto.com/cooks-distance/
      • https://www.mathworks.com/help/stats/cooks-distance.html
      • https://rpubs.com/DragonflyStats/Cooks-Distance
      • https://www.machinelearningplus.com/machine-learning/cooks-distance/
      • Cook, R. Dennis (February 1977). “Detection of Influential Observations in Linear Regression”. Technometrics (American Statistical Association)).

      Thứ Ba, 9 tháng 4, 2024

      Handling Outliers


      (Nguồn: https://www.kaggle.com/discussions/general/465639)


      Loại bỏ các ngoại lệ (Removing outliers)

      • Cách tiếp cận đơn giản nhất là loại bỏ outliers khỏi tập dữ liệu. Tuy nhiên, điều này chỉ nên được thực hiện một cách thận trọng. Một số outliers là do lỗi nhập liệu thì có thể được loại bỏ một cách an toàn. Nhưng những outliers khác có thể là điểm dữ liệu hợp lệ và việc xóa chúng có thể làm sai lệch kết quả. Tốt nhất nên kiểm tra từng trường hợp ngoại lệ để xác định xem nên giữ lại hay nên loại bỏ.

      Gán giá trị thay thế (Imputation)

      • Kỹ thuật imputation hàm ý đến việc thay thế các giá trị outliers bằng các giá trị cụ thể, chẳng như giá trị trung bình, trung vị hoặc số mode. Điều này cho phép bạn giữ lại điểm dữ liệu nhưng thay thế giá trị "dự đoán có căn cứ" cho giá trị ngoại lệ. Việc quy kết làm giảm tác động của các ngoại lệ nhưng vẫn giữ được điểm dữ liệu trong phân tích.

      Gán giá trị thay thế bằng các phân vị đuôi (Winsorization)

      • Winsorization liên quan đến việc thay thế các outliers bằng giá trị ở các phân vị đuôi nhưng chưa đến mức bất thường. Ví dụ: thay thế các giá trị nhỏ hơn phân vị 0.05 bằng chính giá trị phân vị 0.05 và trên phân vị 0.95 bằng giá trị phân vị 0.95. Việc thay thế này giúp giảm thiểu ảnh hưởng của các ngoại lệ mà không loại bỏ chúng khỏi dữ liệu.


      Sử dụng các đại lượng thống kê có tính ổn định (robust statistics)

      • Có một số đại lượng thống kê ít bị ảnh hưởng bởi giá trị outliers hơn những đại lượng thống kê khác. Ví dụ, số trung vị ổn định (ít bị ảnh hưởng bởi outliers) hơn số trung bình. Các kiểm định phi tham số cũng ổn định hơn các kiểmđịnh tham số. 

      Gắn cờ (Flagging):
      • Kỹ thuật này yêu cầu tạo ra một biến bổ sung, có thể là biến giả, để cho biết liệu một điểm dữ liệu có phải là một outlier hay không. Tính năng này hữu ích khi bạn muốn giữ lại tất cả thông tin nhưng cho phép xử lý các ngoại lệ khác nhau trong phân tích của mình.

      Phân vùng dữ liệu (Data Partitioning):
      • Kỹ thuật liên quan đến việc xem  xét tập dữ liệu trong hai trường hợp: một tập hợp có giá trị outliers và một tập hợp không có. Kết quả xử lý trên hai tập dữ liệu này được so sánh vói nhau. 
      Nguồn tài liệu:
      • https://www.naukri.com/code360/library/handling-outliers-in-data-science
      • https://www.kaggle.com/discussions/general/465639

      Chủ Nhật, 7 tháng 4, 2024

      Finding Outliers in a multivariated way

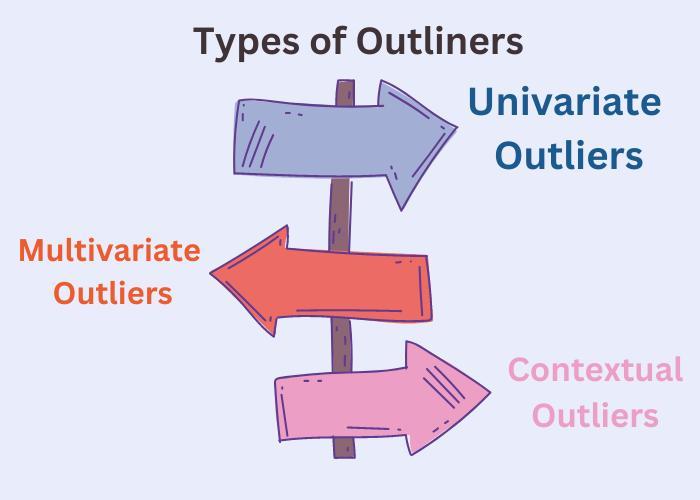
       An outlier is an observation which deviates so much from the other observations as to arouse suspicions that it was generated by a different mechanism.” – D. M. Hawkins


      (Nguồn: https://files.codingninjas.in/article_images/handling-outliers-in-data-science-1-1693163435.webp)


      Hầu hết các phương pháp phát hiện multivariate outliers đều dựa vào các thước đo khoảng cách. Sau khi tính toán khoảng cách theo thước đo chọn trước, các quan sát nào có quan sát lớn hơn một giá trị ngưỡng nhất định được coi là ngoại lệ.

      Tuy nhiên, cần lưu ý rằng, các phương pháp phát hiện multivariate outliers nhằm cung cấp thông tin cho nhà nghiên cứu để cân nhắc xử lý quan sát bất thường chứ không phải là một quy trình tự động hóa mà có thể tùy tiện áp dụng. Việc phát hiện và xử lý các outliers là một quá trình mang tính chủ quan của nhà nghiên cứu. Nó thay đổi dựa trên các mục tiêu, quan điểm và khung lý thuyết nghiên cứu khác nhau.

      Các phương pháp pháp hiện multivariate outliers có thể được chia thành các phân loại như sau: 

      Model-specific methods

      • Cook’s Distance
      • Pareto

      Multivariate methods

      • Mahalanobis Distance
      • Robust Mahalanobis Distance
      • Minimum Covariance Determinant (MCD)
      • robust tolerance ellipsoid (RTE)
      • Invariant Coordinate Selection (ICS)
      • OPTICS
      • Isolation Forest
      • Local Outlier Factor

      Nguồn tài liệu:

      • https://ouzhang.me/blog/outlier-series/outliers-part4/ 

      AI overreliance

       AI overreliance là sự phụ thuộc quá mức vào trí tuệ nhân tạo, xảy ra khi người dùng tin tưởng hoặc làm theo kết quả do AI đưa ra mà thiếu k...