Thứ Ba, 3 tháng 11, 2026

Blue carbon

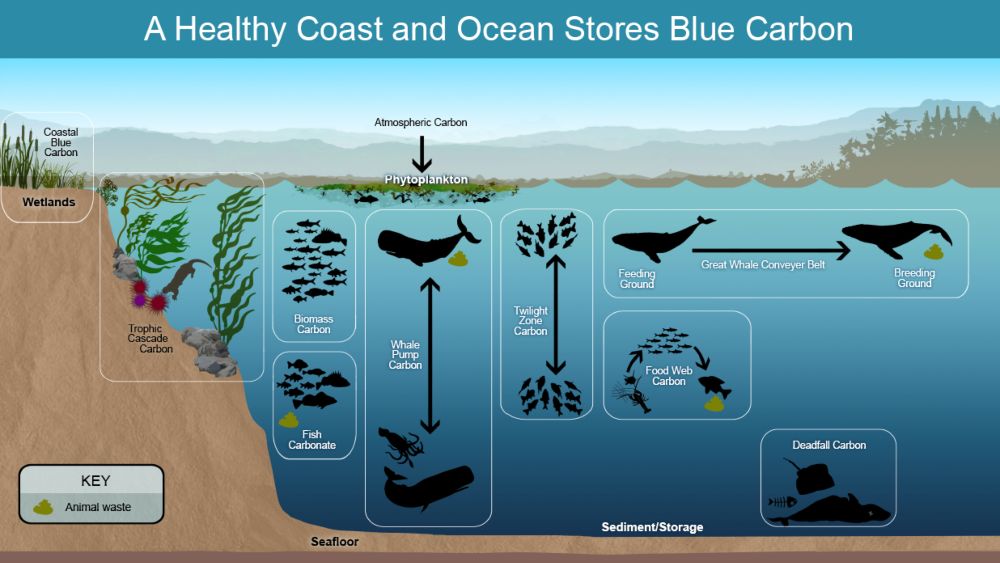
Blue carbon (carbon xanh lam) là lượng carbon được hấp thụ và lưu trữ bởi các hệ sinh thái biển và ven biển. Ba hệ sinh thái chính là:

  • Rừng ngập mặn
  • Thảm cỏ biển
  • Đầm lầy nước mặn (salt marsh)

Tên gọi “blue” để phân biệt với green carbon, tức carbon lưu trữ trong rừng và thực vật trên cạn.


(Nguồn: https://sustainabletravel.org/what-is-blue-carbon/)


Vì sao blue carbon quan trọng?

  • Hệ sinh thái này hấp thụ carbon rất hiệu quả, tính trên mỗi hecta, các hệ sinh thái này có thể lưu trữ carbon nhiều gấp vài lần rừng nhiệt đới trên cạn.
  • Phần lớn carbon nằm trong lớp trầm tích ngập nước, nơi thiếu oxy nên chất hữu cơ phân hủy rất chậm. Carbon có thể được giữ hàng trăm đến hàng nghìn năm.
  • Hệ sinh thái blue carbon giúp chắn sóng, chống xói lở bờ biển, giảm tác động bão, là nơi sinh sản của tôm cá và nguồn sinh kế cho cộng đồng ven biển.

(Nguồn: https://farallones.noaa.gov/education/resources.html)


Tuy nhiên, nếu các hệ sinh thái này bị phá hủy, ví dụ chặt rừng ngập mặn để nuôi tôm hay lấn biển, lượng carbon tích tụ lâu năm sẽ bị giải phóng trở lại khí quyển. Khi đó chúng chuyển từ nơi hấp thụ thành nguồn phát thải.


Tài liệu tham khảo và đọc thêm

  • https://oceanservice.noaa.gov/facts/bluecarbon.html
  • https://vtv.vn/kho-bau-dai-duong-blue-carbon-giup-giam-phat-thai-phuc-hoi-he-sinh-thai-100250725143125596.htm
  • https://blog.wcs.org/photo/2021/12/02/what-is-blue-carbon-and-why-is-it-important/

Chủ Nhật, 1 tháng 11, 2026

Carbon leakage

Carbon leakage (rò rỉ carbon) là hiện tượng khi một quốc gia hoặc khu vực áp dụng chính sách khí hậu chặt chẽ (như thuế carbon hay hệ thống mua bán phát thải), các doanh nghiệp chuyển sản xuất sang nơi có quy định lỏng lẻo hơn để tránh chi phí. Kết quả là lượng phát thải không giảm mà chỉ “chuyển chỗ”, thậm chí có thể tăng lên nếu nơi mới sản xuất kém hiệu quả hơn.


(Nguồn: https://www.weyer-gruppe.com/en/2022/05/24/the-most-frequently-asked-questions-about-carbon-leakage/)


Một số ví dụ:

  • Doanh nghiệp di dời nhà máy hoặc đầu tư mới ra nước ngoài.
  • Hàng nhập khẩu rẻ hơn (do không chịu chi phí carbon) thay thế hàng sản xuất trong nước.
  • Khi một khu vực giảm dùng nhiên liệu hóa thạch, giá dầu và than thế giới giảm, khiến nơi khác dùng nhiều hơn.

Tài liệu tham khảo và đọc thêm

  • https://www.lse.ac.uk/granthaminstitute/news/what-is-carbon-leakage-clarifying-misconceptions-for-a-better-mitigation-effort/
  • https://clear.ucdavis.edu/news/what-carbon-leakage

Thứ Sáu, 30 tháng 10, 2026

Lithography

Lithography có nghĩa gốc là in thạch bản. Trong lĩnh vực chế tạo chip, từ này thường chỉ quang khắc (photolithography) — quá trình dùng ánh sáng để chuyển mẫu thiết kế mạch lên một lớp vật liệu nhạy sáng trên bề mặt wafer.


(Nguồn: https://inc42.com/glossary/immersion-lithography/)


Có thể hình dung quang khắc giống như “in bản thiết kế siêu nhỏ” lên tấm silicon, để xác định nơi sẽ tạo các chi tiết của mạch điện.


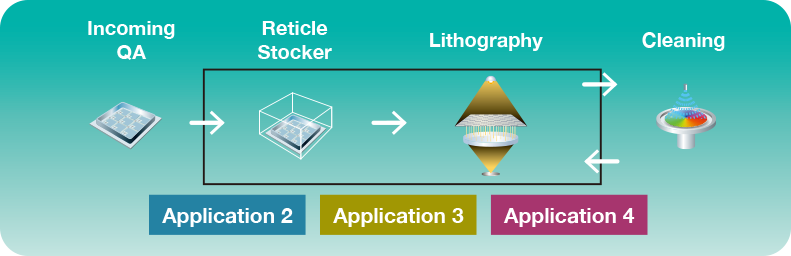
Quy trình cơ bản gồm:

  • Phủ lớp nhạy sáng bằng cách phủ một lớp vật liệu gọi là photoresist lên wafer.
  • Chiếu mẫu bằng ánh sáng, khi đó hệ thống quang học đưa hình ảnh từ mặt nạ chứa mẫu thiết kế (photomask) lên lớp nhạy sáng.
  •  Dùng dung dịch để loại bỏ những phần nhất định của lớp nhạy sáng, tạo ra mẫu cần thiết.
  • Xử lý lớp vật liệu bên dưới, dựa vào mẫu đó để khắc, đưa tạp chất vào hoặc thực hiện các bước chế tạo khác.

Quang khắc chủ yếu tạo mẫu; công đoạn khắc vật liệu (etching) là một bước riêng. Quy trình tạo mẫu và xử lý được lặp lại nhiều lần để hình thành các lớp cấu trúc của chip.


(Nguồn: https://static.horiba.com/fileadmin/Horiba/Application/Lithography/Lithography_Process.png )


Không phải mọi kỹ thuật lithography đều dùng ánh sáng; chẳng hạn, electron-beam lithography dùng chùm electron để tạo mẫu.


Tài liệu đọc thêm và tham khảo

  • https://inc42.com/glossary/immersion-lithography/
  • https://www.asml.com/en/technology/lithography-principles
  • https://www.synopsys.com/glossary/what-is-lithography.html
  • https://www.horiba.com/int/semiconductor/process/lithography/

Thứ Tư, 28 tháng 10, 2026

Deep Ultraviolet

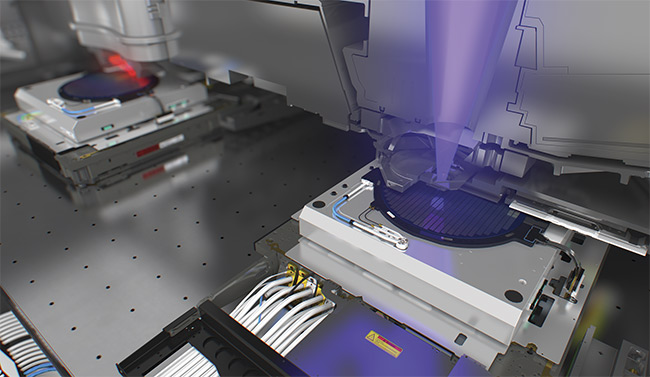
DUV (Deep Ultraviolet), tức tia cực tím sâu, là ánh sáng có bước sóng khoảng 190–280 nm. Trong ngành bán dẫn, quang khắc DUV là công nghệ in mạch lên chip đã dùng từ những năm 1990 và đến nay vẫn là công nghệ được dùng nhiều nhất.

Hai loại DUV chính

  • KrF (krypton fluoride), bước sóng 248 nm, dùng cho các lớp mạch ít đòi hỏi độ chính xác.
  • ArF (argon fluoride), bước sóng 193 nm, dùng cho các lớp chi tiết hơn.


(Nguồn: https://www.photonics.com/Articles/As-DUV-Lithography-Rallies-Demand-for-ArF-Lasers/a67013 )


Cả hai dùng laser excimer, nghĩa là hỗn hợp khí hiếm và flo được kích thích bằng điện để phát ra tia cực tím. Cách này đơn giản hơn nhiều so với nguồn plasma thiếc của EUV.

Các kỹ thuật giúp DUV in được chi tiết nhỏ

  • Quang khắc nhúng (immersion lithography): đặt một lớp nước giữa thấu kính và tấm wafer. Nước làm ánh sáng “ngắn” lại một cách hiệu quả, nên máy ArF nhúng có thể in chi tiết nhỏ như thể dùng bước sóng khoảng 134 nm.
  • Chiếu nhiều lần (multi-patterning): chia một mẫu mạch dày đặc thành nhiều lần chiếu riêng. Nhờ vậy DUV có thể làm được chip 7 nm, thậm chí 5 nm, nhưng tốn thời gian, chi phí và dễ phát sinh lỗi hơn.

(Nguồn:https://www.digi-electronics.com/en/blogs/duv-vs-euv-lithography-performance-cost-applications/767.html )


Ngay cả trong một con chip tiên tiến nhất, chỉ vài lớp quan trọng nhất cần đến EUV. Phần lớn các lớp còn lại vẫn in bằng DUV vì rẻ và nhanh hơn. Các loại chip như vi điều khiển, chip ô tô, chip quản lý nguồn thì gần như hoàn toàn dùng DUV.

Tài liệu đọc thêm và tham khảo

  • https://www.photonics.com/Dictionary/deep-ultraviolet/d8156
  • https://optodiode.com/our_blog/what-is-euv-duv/
  • https://www.zeiss.com/semiconductor-manufacturing-technology/smt-magazine/duv-lithography.html

Thứ Hai, 26 tháng 10, 2026

Extreme Ultraviolet

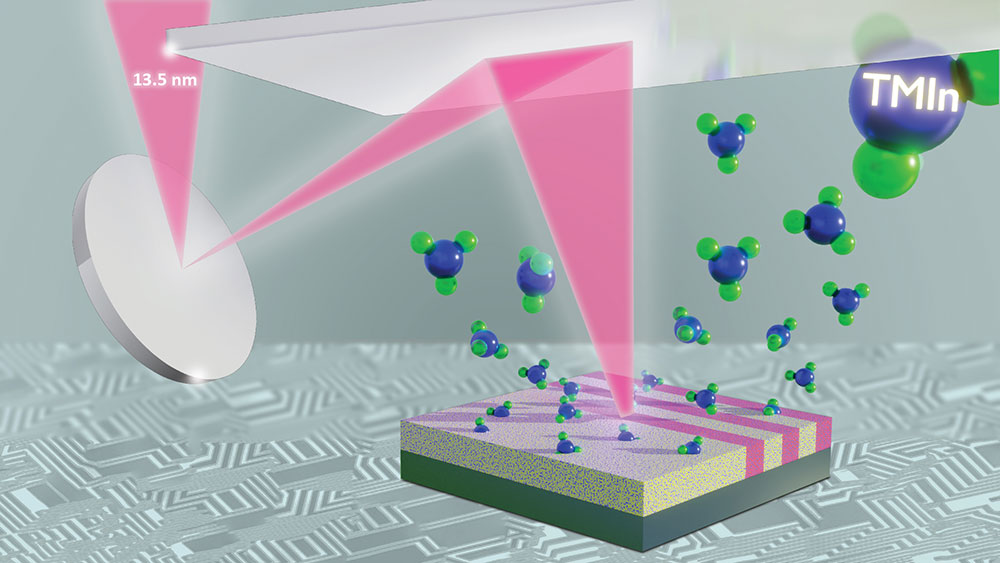
Extreme Ultraviolet (EUV), tức tia cực tím cực ngắn, là bức xạ điện từ có bước sóng khoảng 10–124 nm, nằm giữa tia cực tím thông thường và tia X mềm. Trong công nghiệp, cụm từ này thường dùng để chỉ quang khắc EUV (EUV lithography), công nghệ dùng ánh sáng bước sóng 13,5 nm để in mạch lên chip bán dẫn.

Vì sao EUV quan trọng?

Trong quang khắc, bước sóng càng ngắn thì chi tiết in được càng nhỏ. Công nghệ cũ (DUV) dùng ánh sáng 193 nm, nên để làm chip tiên tiến phải chiếu nhiều lần (multi-patterning), vừa tốn kém vừa dễ lỗi. EUV ngắn hơn khoảng 14 lần, cho phép in các cấu trúc rất nhỏ chỉ trong một lần chiếu. Đây là nền tảng để sản xuất chip ở các tiến trình 7 nm, 5 nm, 3 nm và nhỏ hơn, dùng trong điện thoại, máy tính và chip AI.


(Nguồn: https://www.bnl.gov/newsroom/news.php?a=221436)

Cách tạo ra ánh sáng EUV

Ánh sáng EUV không có sẵn từ đèn thông thường. Máy bắn laser CO₂ công suất lớn vào những giọt thiếc nóng chảy cực nhỏ, khoảng 50.000 giọt mỗi giây. Thiếc bị biến thành plasma nóng hàng trăm nghìn độ và phát ra ánh sáng 13,5 nm.

Ai làm ra máy EUV?

Công ty ASML (Hà Lan) là nhà sản xuất máy quang khắc EUV thương mại duy nhất trên thế giới. Mỗi máy có kích thước bằng một chiếc xe buýt và giá hàng trăm triệu USD. Các khách hàng chính là TSMC, Samsung và Intel. Do tầm quan trọng chiến lược, máy EUV cũng là đối tượng của các biện pháp kiểm soát xuất khẩu.


(Nguồn: https://andcable.com/data-center-trends/extreme-ultraviolet-euv-lithography-moores-law/)


Ngoài sản xuất chip, EUV còn được dùng trong thiên văn học, ví dụ để quan sát vành nhật hoa của Mặt Trời, và trong nghiên cứu vật lý.

Tài liệu tham khảo và đọc thêm

  • https://www.universitywafer.com/euv.html
  • https://research.ibm.com/blog/what-is-euv-lithography


Thứ Bảy, 24 tháng 10, 2026

Fingerprinting

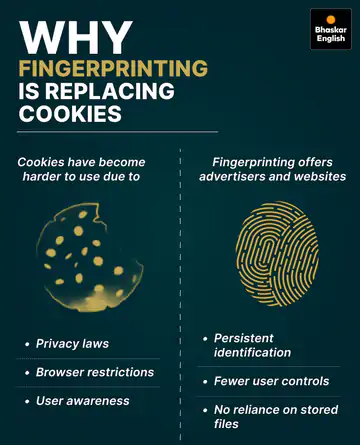
 Fingerprinting (lấy dấu vân tay số) là kỹ thuật kết hợp các đặc điểm của trình duyệt hoặc thiết bị để tạo ra một “dấu vân tay”, giúp nhận diện hoặc phân biệt người dùng khi họ truy cập Internet.

Những đặc điểm này có thể gồm:

  • Loại trình duyệt, hệ điều hành.
  • Độ phân giải màn hình, múi giờ, ngôn ngữ.
  • Phông chữ được cài đặt.
  • Cách thiết bị xử lý hình ảnh và âm thanh.


(Nguồn:https://hidemyacc.com/browser-fingerprint )

Ví dụ: Một website kết hợp thông tin “Chrome trên Windows, màn hình 1920 × 1080, múi giờ GMT+7, tiếng Việt…” cùng nhiều đặc điểm khác để nhận ra một trình duyệt có khả năng đã từng truy cập, ngay cả khi người dùng đã xóa cookie.


(Nguồn: https://www.bhaskarenglish.in/tech-science/news/apple-warns-iphone-users-about-fingerprint-tracking-what-device-fingerprinting-how-does-invisible-tech-affect-phones-136658981.html)

Fingerprinting có thể được dùng để phát hiện gian lận, bảo vệ tài khoản, nhưng cũng để theo dõi hành vi và phục vụ quảng cáo. Dấu vân tay này không nhất thiết cho biết tên thật và không bảo đảm nhận diện chính xác tuyệt đối: nhiều thiết bị có thể giống nhau, còn đặc điểm của một thiết bị có thể thay đổi.

Tài liệu tham khảo và đọc thêm

  • https://www.brandsvietnam.com/congdong/topic/browser-fingerprinting-khai-niem-ky-thuat-dang-am-tham-thay-doi-cach-lam-digital-marketing
  • https://fingerprint.com/blog/device-fingerprinting/

Thứ Năm, 22 tháng 10, 2026

Tracking pixel

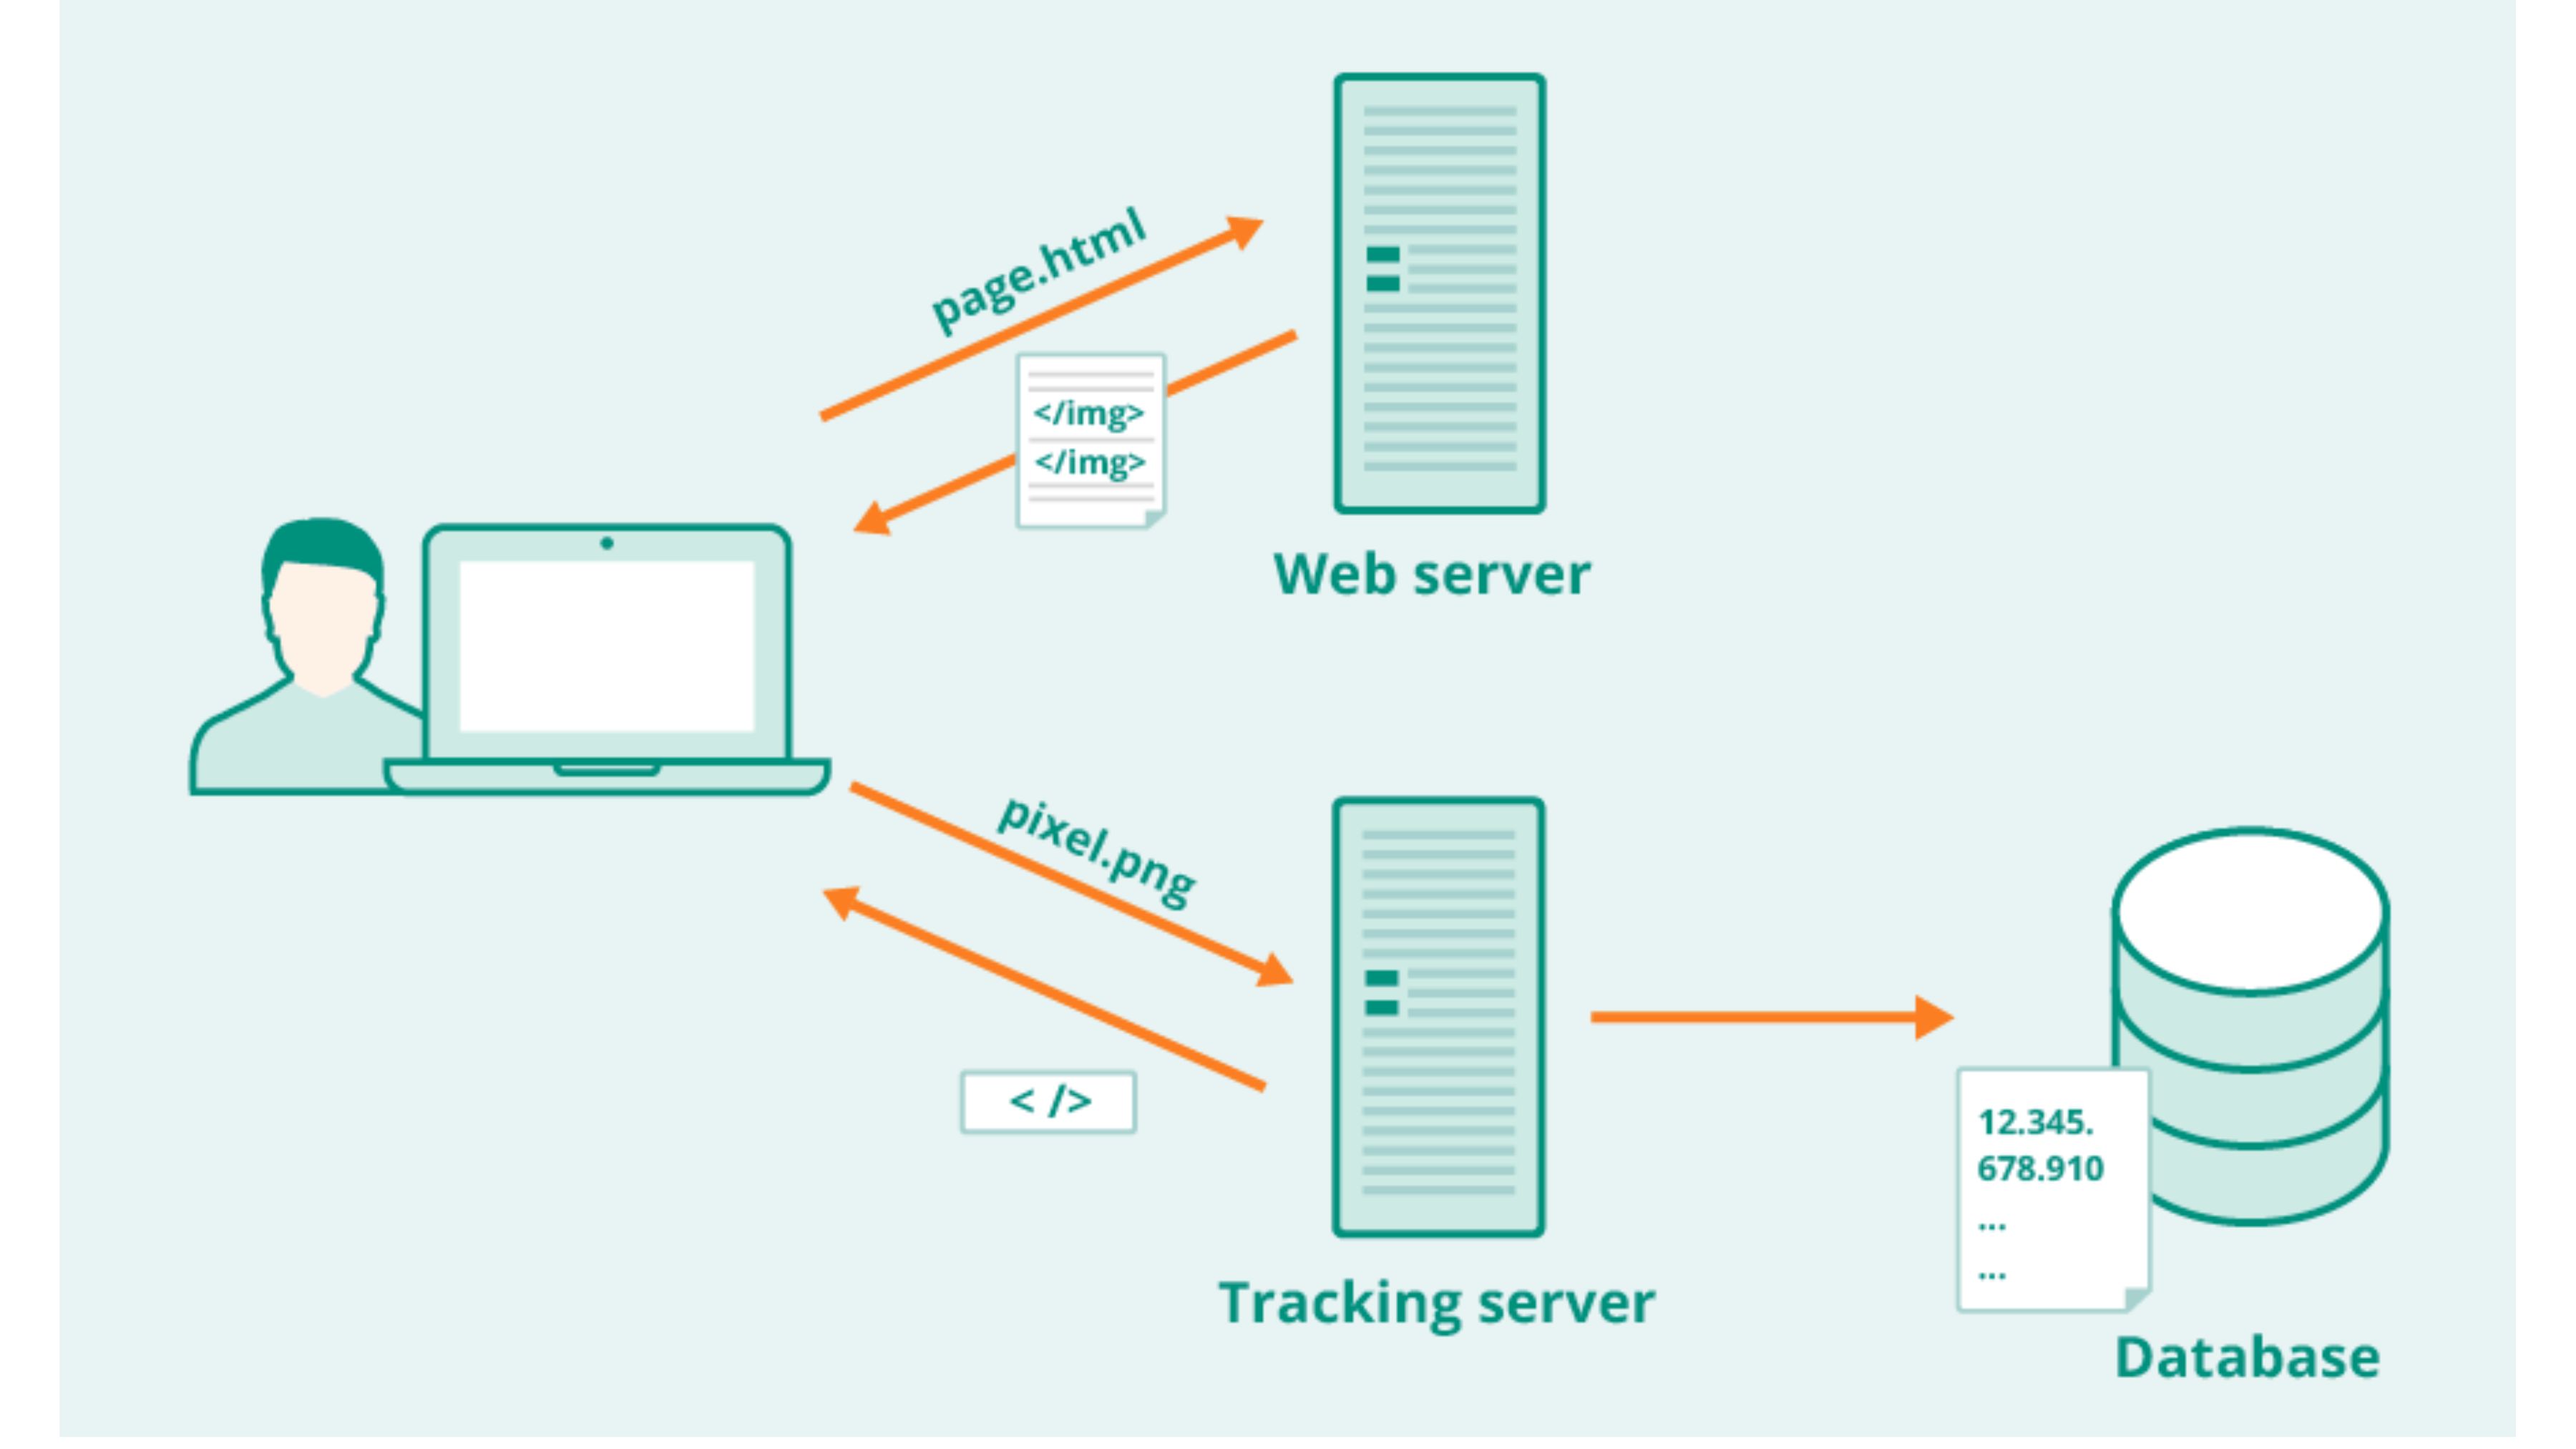
Tracking pixel (pixel theo dõi) là một thành phần rất nhỏ được nhúng vào website hoặc email để ghi nhận hoạt động của người dùng. Dạng truyền thống thường là ảnh trong suốt kích thước 1 × 1 pixel, gần như không thể nhìn thấy.


(Nguồn: https://smartads.tech/blog/detail/tracking-pixel-la-gi-va-cach-su-dung-the-nao--Fi4tFVBdclNcWQ==.html )

Khi bạn mở trang web hoặc email, trình duyệt hay ứng dụng email gửi yêu cầu tải pixel từ máy chủ. Yêu cầu này có thể giúp bên theo dõi ghi nhận thời điểm tải, địa chỉ IP và một số thông tin về trình duyệt hoặc thiết bị.

Ví dụ:

  • Trong email, Tracking pixel ghi nhận việc tải ảnh để suy đoán email đã được mở. Kết quả không hoàn toàn chính xác vì ứng dụng có thể chặn ảnh hoặc tự tải ảnh trước.


  • Trên website, Tracking pixel ghi nhận lượt truy cập một trang hoặc hành động như mua hàng, phục vụ đo lường quảng cáo.

(Nguồn: https://usercentrics.com/guides/marketing-measurement/tracking-pixels/)


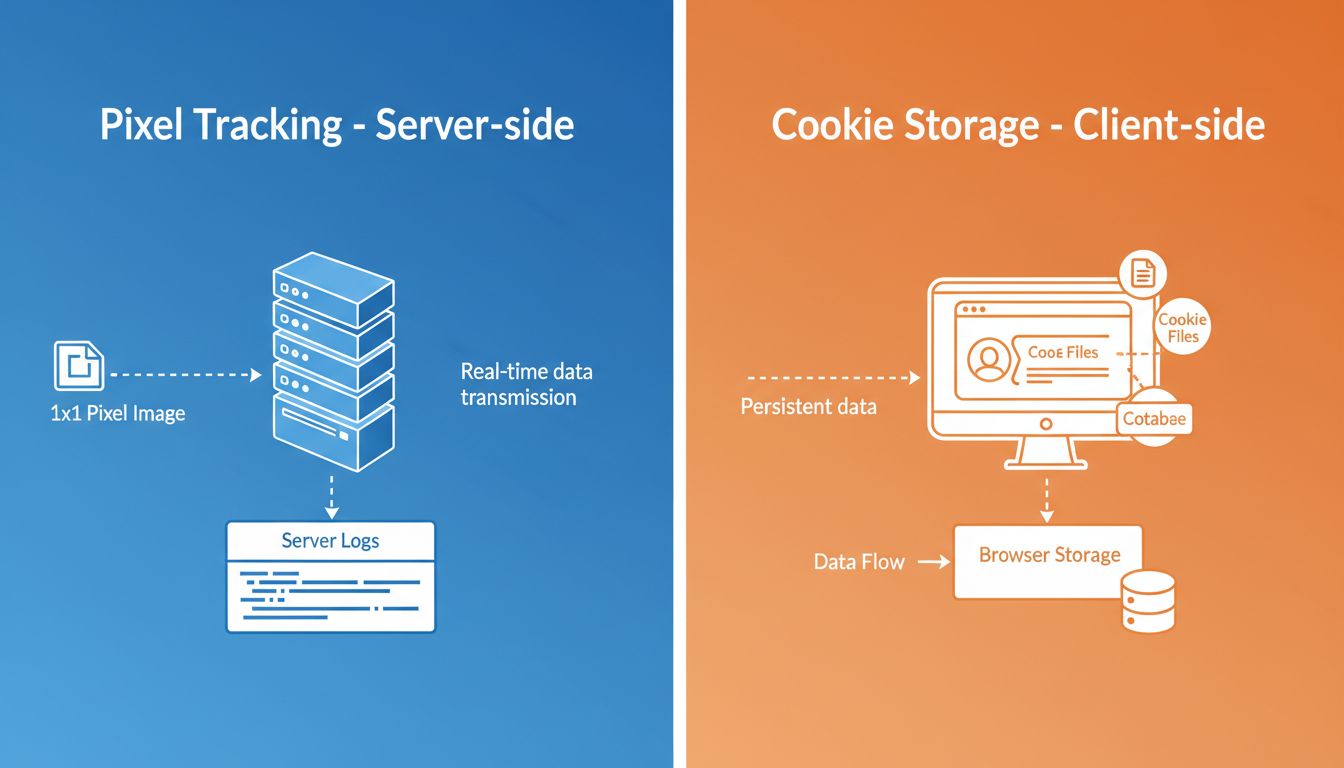
Tracking pixel khác với cookie. Cookie lưu một mẩu dữ liệu trong trình duyệt; tracking pixel tạo yêu cầu gửi đến máy chủ khi được tải. Hai công nghệ có thể phối hợp để liên kết các lần truy cập và theo dõi hành vi.


(Nguồn: https://www.postaffiliatepro.com/faq/pixel-tracking-vs-cookies/)


Tài liệu tham khảo vả đọc thêm

  • https://smartads.tech/blog/detail/what-is-a-tracking-pixel-and-how-does-it-work--Fi4tFVBdclNcWQ==.html
  • https://interdigi.vn/tracking-pixel-la-gi/
  • https://usercentrics.com/guides/marketing-measurement/tracking-pixels/

Thứ Ba, 20 tháng 10, 2026

Dynamic pricing

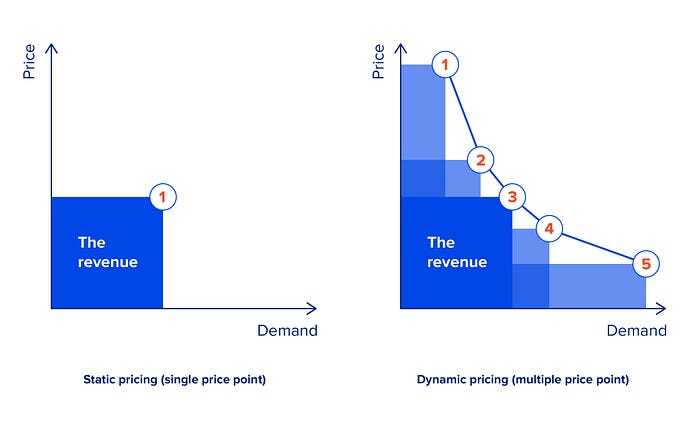
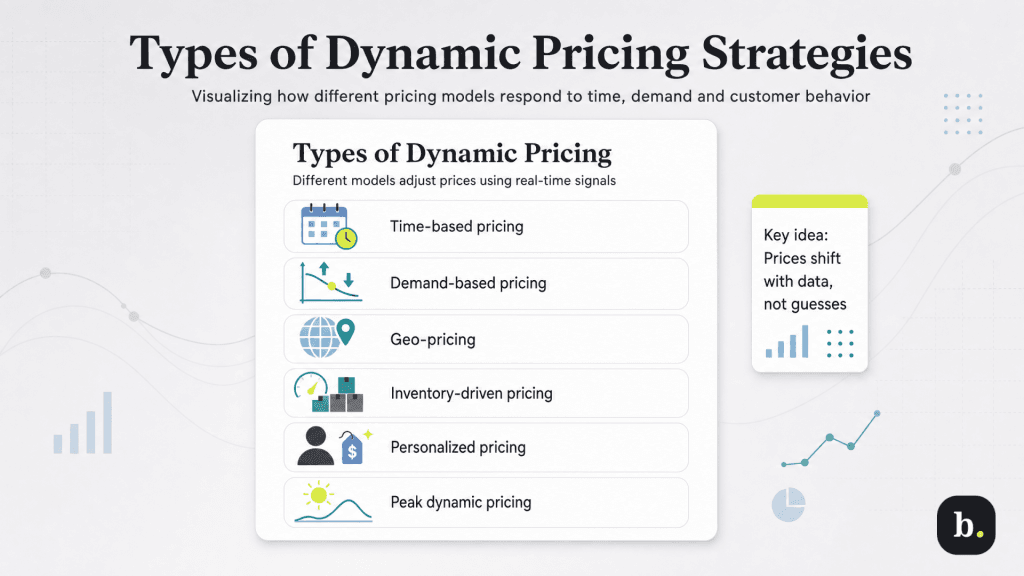
 Dynamic pricing (định giá động) là cách doanh nghiệp điều chỉnh giá theo thời gian dựa trên cung–cầu và điều kiện thị trường, thay vì giữ một mức giá cố định.


(Nguồn: https://www.ml6.eu/en/blog/dynamic-pricing-pricing-model-explainability-market-experiment-data-insights)


Ví dụ:

  • Xe công nghệ: Giá tăng vào giờ cao điểm khi nhiều người đặt xe nhưng ít tài xế.
  • Vé máy bay: Giá thay đổi theo nhu cầu, số ghế còn lại và thời gian đến ngày khởi hành.
  • Khách sạn: Giá phòng tăng vào dịp lễ hoặc khi tỷ lệ đặt phòng cao.
  • Thương mại điện tử: Giá thay đổi theo lượng hàng tồn kho hoặc giá của đối thủ

(Nguồn: https://www.business.com/articles/what-is-dynamic-pricing-and-how-does-it-affect-ecommerce/ )


Định giá động không mặc nhiên là định giá dựa trên giám sát, dù doanh nghiệp có thể kết hợp cả hai.

Tài liệu tham khảo và đọc thêm

  • https://www.brookings.edu/articles/what-is-dynamic-pricing-and-why-do-consumers-need-better-protections/
  • https://online.hbs.edu/blog/post/what-is-dynamic-pricing
  • https://www.salesforce.com/blog/sales/dynamic-pricing/
  • https://www.business.com/articles/what-is-dynamic-pricing-and-how-does-it-affect-ecommerce/

Chủ Nhật, 18 tháng 10, 2026

surveillance pricing

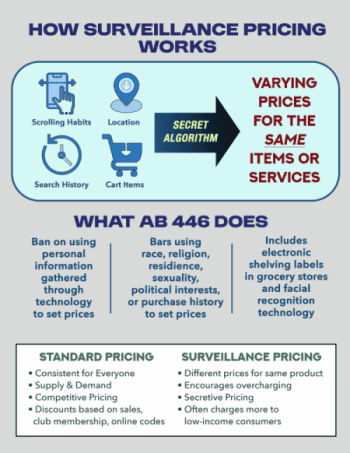
 Surveillance pricing có thể dịch là “định giá dựa trên dữ liệu theo dõi người tiêu dùng”, hoặc ngắn gọn là “định giá dựa trên giám sát”.


(Nguồn: https://consumerwatchdog.org/privacy/surveillance-pricing-bill-passes-out-of-ca-senate-judiciary/ )


Đây là việc doanh nghiệp sử dụng dữ liệu thu thập hoặc suy luận về từng khách hàng—như lịch sử duyệt web, vị trí, hành vi mua sắm, thiết bị sử dụng hay khả năng chi trả—để quyết định mức giá hoặc ưu đãi dành cho người đó. Vì vậy, hai người có thể được chào giá khác nhau cho cùng một sản phẩm tại cùng thời điểm.


(Nguồn:  https://www.syracuse.com/business/2026/09/new-york-is-poised-to-ban-price-changes-based-on-income-age-and-even-race-would-it-work.html)


Điểm gây lo ngại của surveillance pricing là việc sử dụng dữ liệu cá nhân để khai thác mức sẵn lòng chi trả, trong khi người mua có thể không biết vì sao mình nhận mức giá đó.


Tài liệu tham khảo

  • https://epic.org/issues/consumer-privacy/surveillance-pricing/
  • https://www.law.cornell.edu/wex/surveillance_pricing

Thứ Sáu, 16 tháng 10, 2026

Consent fatigue

Consent fatigue có thể dịch là “sự mệt mỏi do phải đưa ra sự đồng ý quá nhiều lần”, hoặc ngắn gọn là “mệt mỏi vì yêu cầu đồng ý”.

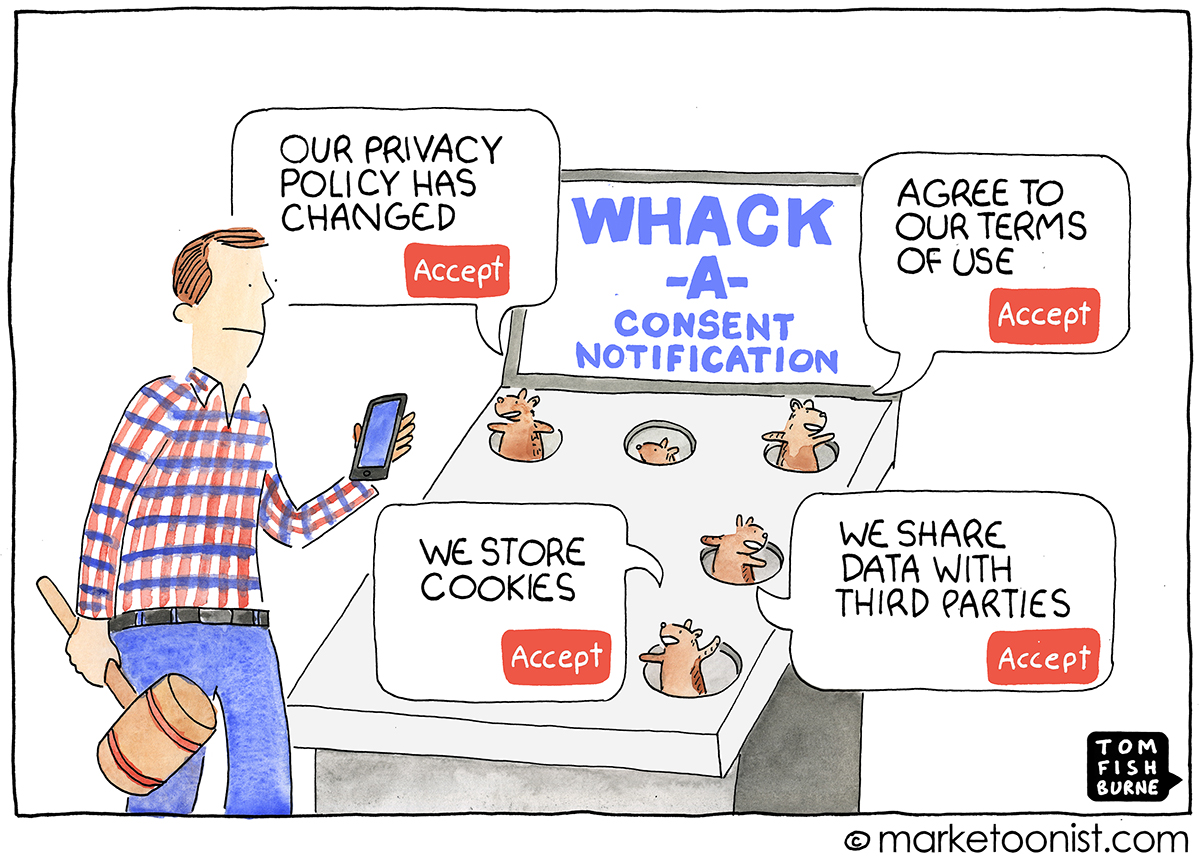
Trong bảo vệ dữ liệu cá nhân, thuật ngữ này chỉ tình trạng người dùng liên tục gặp các yêu cầu chấp thuận thu thập, sử dụng hoặc chia sẻ dữ liệu, đến mức không còn đủ thời gian và sự chú ý để cân nhắc từng yêu cầu. Họ có thể bấm “Đồng ý” một cách máy móc để tiếp tục sử dụng dịch vụ, thay vì thực sự đọc và hiểu nội dung.


(Nguồn: https://wplegalpages.com/blog/consent-fatigue-too-many-popups-hurt-privacy-trust/)


Ví dụ: khi truy cập nhiều website, người dùng liên tục phải chọn tùy chỉnh cookie hoặc chấp nhận tất cả. Sau nhiều lần, họ chọn “Chấp nhận tất cả” chỉ để đóng thông báo.


(Nguồn: https://marketoonist.com/2019/05/data-privacy-consent-fatigue-and-gdpr.html )


Tình trạng mệt mỏi do các yêu cầu đồng ý lặp lại (consent fatigue) có thể khiến chủ thể dữ liệu chấp thuận một cách máy móc, làm suy giảm ý nghĩa thực chất của cơ chế đồng ý trong bảo vệ dữ liệu cá nhân.

Tài liệu tham khảo

  • https://amlegals.com/what-is-consent-fatigue/
  • https://www.talkinghealthtech.com/glossary/consent-fatigue


Thứ Tư, 14 tháng 10, 2026

ELIZA Effect

ELIZA Effect là hiện tượng tâm lý khi con người vô thức gán trí thông minh, cảm xúc hoặc sự hiểu biết cho hệ thống máy tính, dù thực tế hệ thống đó không hề "hiểu" gì cả.

Tên này lấy từ ELIZA — một chương trình chatbot do Joseph Weizenbaum tạo ra tại MIT vào năm 1966. ELIZA mô phỏng một nhà trị liệu tâm lý bằng cách dùng các quy tắc đơn giản: nhận diện từ khóa trong câu người dùng rồi phản hồi bằng câu hỏi mẫu.

Ví dụ:

  • Người dùng: "Tôi buồn vì mẹ tôi."
  • ELIZA: "Hãy kể thêm về mẹ bạn."

(Nguồn:  https://www.nngroup.com/articles/eliza-effect-ai/)


ELIZA chỉ làm pattern matching thuần túy, không hiểu ngữ nghĩa. Nhưng điều bất ngờ là nhiều người dùng thực sự tin rằng ELIZA hiểu họ, thậm chí muốn tâm sự riêng với nó. Chính Weizenbaum cũng sốc trước phản ứng này.

Tại sao hiệu ứng này xảy ra?

  • Con người có xu hướng tự nhiên nhân cách hóa (anthropomorphize) mọi thứ, từ thú cưng đến máy tính.
  • Confirmation bias: Người dùng chủ động diễn giải các phản hồi mơ hồ theo hướng có ý nghĩa.
  • Ngôn ngữ tự nhiên tạo ảo giác về sự hiểu biết — nếu máy "trả lời" được thì chắc nó "hiểu".

Ý nghĩa trong thời đại AI hiện nay

ELIZA Effect đặc biệt liên quan trong bối cảnh các LLM như ChatGPT, Claude:

  • Người dùng dễ tin rằng AI có cảm xúc, quan điểm, hoặc ý thức, trong khi thực chất mô hình đang dự đoán token tiếp theo dựa trên xác suất thống kê. Dẫn đến tin tưởng quá mức vào câu trả lời của AI, bỏ qua việc kiểm chứng. 

(Nguồn: https://www.0x4a6f65.com/)


Tóm lại, ELIZA Effect nhắc nhở rằng: một hệ thống trả lời trôi chảy không đồng nghĩa với việc nó hiểu. Đây là bài học quan trọng khi thiết kế, sử dụng và đánh giá các hệ thống AI tương tác với con người.

Tài liệu đọc thêm và tham khảo

  • https://www.ibm.com/think/insights/eliza-effect-avoiding-emotional-attachment-to-ai
  • https://builtin.com/artificial-intelligence/eliza-effect
  • https://www.nngroup.com/articles/eliza-effect-ai/

Thứ Hai, 12 tháng 10, 2026

Edge AI

Edge AI là công nghệ cho phép xử lý trí tuệ nhân tạo ngay trên thiết bị như camera, điện thoại hoặc máy tính cục bộ. Thay vì gửi toàn bộ dữ liệu lên đám mây, thiết bị sử dụng mô hình AI đã được huấn luyện để phân tích và đưa ra kết quả tại chỗ.


(Nguồn: https://arxiv.org/html/2501.03265v1)


Ví dụ, camera trên dây chuyền sản xuất có thể tự phát hiện vết xước trên sản phẩm và gửi cảnh báo, thay vì truyền toàn bộ video đến máy chủ. Edge AI cũng được ứng dụng trong nhận diện khuôn mặt, giám sát an toàn và điều khiển bằng giọng nói.


(Nguồn: https://arxiv.org/html/2501.03265v1)


Nhờ xử lý cục bộ, Edge AI giúp giảm độ trễ, lưu lượng truyền dữ liệu và sự phụ thuộc vào Internet. Việc hạn chế gửi dữ liệu gốc ra ngoài còn hỗ trợ bảo vệ thông tin riêng tư. Tuy nhiên, thiết bị có giới hạn về năng lực tính toán, bộ nhớ và điện năng; những ứng dụng phức tạp có thể cần bộ xử lý AI chuyên dụng.


Tài liệu tham khảo và đọc thêm

  •  https://article.murata.com/en-global/article/what-is-edge-ai
  • https://www.ibm.com/think/topics/edge-ai

Thứ Bảy, 10 tháng 10, 2026

Knowledge Distillation

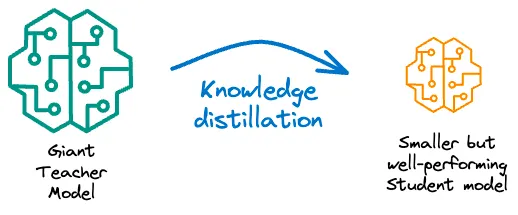
Knowledge Distillation (chưng cất tri thức) là kỹ thuật huấn luyện một mô hình nhỏ, gọi là mô hình học sinh (student), học theo đầu ra hoặc biểu diễn của một mô hình mạnh hơn, gọi là mô hình giáo viên (teacher).


(Nguồn: https://blog.dailydoseofds.com/p/implement-knowledge-distillation)

Mục tiêu là giúp mô hình nhỏ giữ được nhiều năng lực của mô hình lớn, đồng thời giảm chi phí tính toán, dung lượng lưu trữ và thời gian phản hồi. Kỹ thuật này được giới thiệu bởi Geoffrey Hinton và cộng sự trong bài báo "Distilling the Knowledge in a Neural Network" (2015) và hiện được sử dụng rộng rãi trong NLP, computer vision, và cả việc huấn luyện các mô hình ngôn ngữ lớn (LLM).

(Nguồn: https://huggingface.co/blog/Kseniase/kd )

Ví dụ, người dùng muốn xây dựng mô hình phân loại phản hồi của sinh viên. Quá trình có thể diễn ra như sau:

Bước 1: Cho mô hình lớn đọc và phân loại nhiều phản hồi. 

Kết quả từ mô hình lớn

“Thầy giảng dễ hiểu, ví dụ rất thực tế.” Tích cực

“Em chưa hiểu cách làm bài tập.”                 Tiêu cực

“Buổi học bắt đầu lúc 18 giờ.”                 Trung tính


Bước 2: Dùng các cặp phản hồi–kết quả này để huấn luyện mô hình nhỏ. Qua nhiều ví dụ, mô hình nhỏ học những cách diễn đạt thường gắn với từng loại cảm xúc. Nếu tiếp cận được xác suất dự đoán của mô hình lớn, nó còn có thể học mức độ chắc chắn giữa các lựa chọn.

Bước 3: Cho mô hình nhỏ tự xử lý phản hồi mới. Chẳng hạn, khi gặp câu “Các ví dụ giúp em hiểu bài hơn”, mô hình nhỏ có thể phân loại là tích cực, mà không cần hỏi lại mô hình lớn. 


Lợi ích chính là dùng mô hình lớn để huấn luyện, rồi dùng mô hình nhỏ để phục vụ người dùng với chi phí thấp hơn. Mô hình nhỏ có thể làm tốt nhiệm vụ được dạy, nhưng không tự động có toàn bộ năng lực của mô hình lớn và vẫn có thể học theo các lỗi của nó. Khác với việc đưa vài ví dụ vào prompt, quá trình này thực sự huấn luyện và thay đổi trọng số của mô hình nhỏ.


(Nguồn: https://blog.roboflow.com/what-is-knowledge-distillation/)

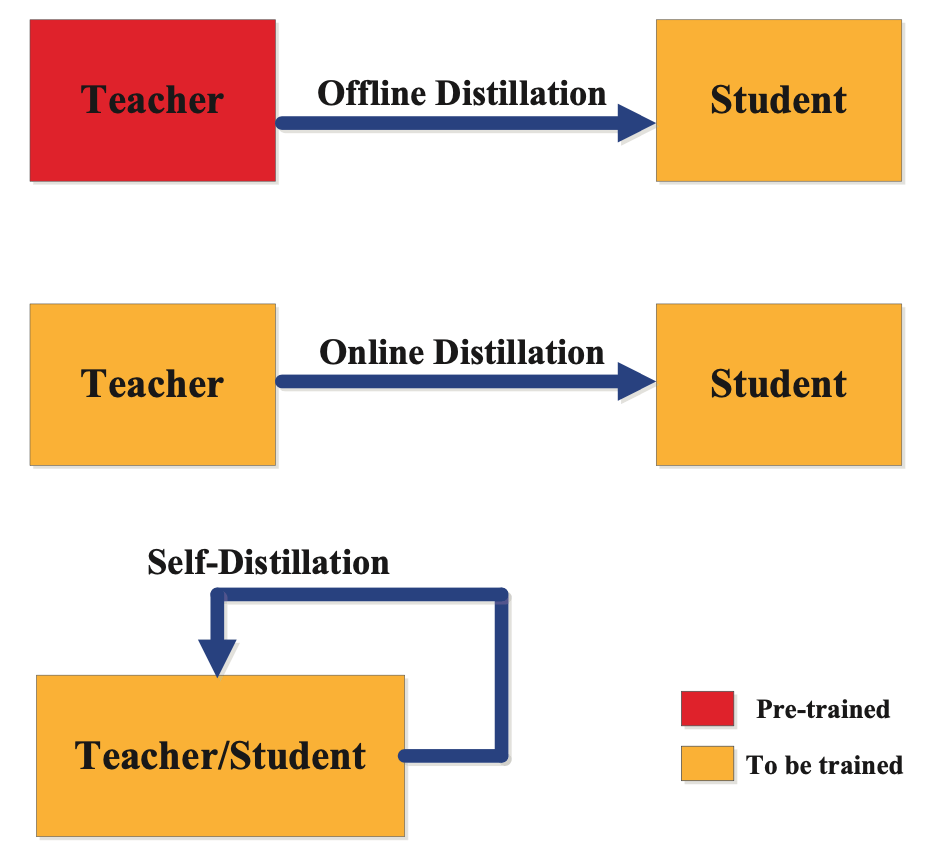
Ba phương pháp Knowledge Distillation


  •  Chưng cất tri thức ngoại tuyến (Offline Distillation)
Trong phương pháp này, mô hình giáo viên được huấn luyện trước, sau đó giữ cố định các tham số. Khi huấn luyện mô hình học sinh, giáo viên cung cấp đầu ra hoặc các biểu diễn trung gian để học sinh học theo, nhưng bản thân giáo viên không được cập nhật.

Có thể hình dung đây là cách “giáo viên đã học xong, sau đó hướng dẫn học sinh”. Nhiều nghiên cứu tập trung cải thiện cách truyền tri thức, chẳng hạn lựa chọn thông tin nào từ giáo viên và thiết kế hàm mất mát để học sinh tiếp thu hiệu quả. Ưu điểm là tận dụng được một mô hình giáo viên đã hoạt động tốt; tuy nhiên, hiệu quả còn phụ thuộc vào mức độ phù hợp giữa giáo viên, học sinh và nhiệm vụ.
  •  Chưng cất tri thức trực tuyến (Online Distillation)
Trong phương pháp này, các mô hình được huấn luyện đồng thời và truyền tri thức cho nhau trong quá trình học. Thay vì luôn dựa vào một giáo viên đã huấn luyện hoàn chỉnh, tín hiệu hướng dẫn có thể đến từ một mô hình đang học, từ nhiều mô hình cùng học hoặc từ kết quả kết hợp của chúng.

Có thể hình dung đây là cách “vừa học, vừa hướng dẫn nhau”. Trong một số thiết kế, các mô hình học hỏi lẫn nhau thông qua dự đoán, giúp mỗi mô hình cải thiện kết quả. Tuy nhiên, cơ chế phản hồi hai chiều không phải yêu cầu bắt buộc của mọi phương pháp. Ví dụ nghiên cứu về huấn luyện đồng thời và học hỏi giữa các mô hình.

Từ “trực tuyến” ở đây đề cập đến việc truyền tri thức ngay trong quá trình huấn luyện. Nó không nhất thiết có nghĩa là sử dụng Internet, tiếp nhận dữ liệu thời gian thực hoặc học liên tục từ dữ liệu mới. Khả năng thích nghi với dữ liệu thay đổi cần được thiết kế và đánh giá riêng.
  •  Tự chưng cất tri thức (Self-Distillation)
Tự chưng cất sử dụng tri thức từ chính mô hình hoặc một phiên bản của mô hình để hướng dẫn việc học, thay vì nhất thiết cần một giáo viên riêng biệt có quy mô lớn hơn. Có thể hình dung đây là cách “mô hình học từ chính mình để cải thiện”.

Trong cách triển khai được mô tả ở đoạn gốc, các bộ phân loại phụ được gắn vào những tầng trung gian của mạng. Phần sâu hơn đóng vai trò giáo viên, hướng dẫn phần nông hơn. Quá trình huấn luyện kết hợp việc giảm khác biệt giữa các dự đoán và giảm khoảng cách giữa các biểu diễn đặc trưng, chẳng hạn bằng hàm mất mát L2. Khi sử dụng mô hình để dự đoán, có thể loại bỏ các nhánh phụ nếu chỉ cần đầu ra cuối cùng. Đây là một hướng tự chưng cất trong cùng mạng.


Tài liệu tham khảo và đọc thêm

  • https://www.ibm.com/think/topics/knowledge-distillation
  • https://huggingface.co/blog/Kseniase/kd
  • https://blog.roboflow.com/what-is-knowledge-distillation/

Thứ Năm, 8 tháng 10, 2026

Few-shot Prompting

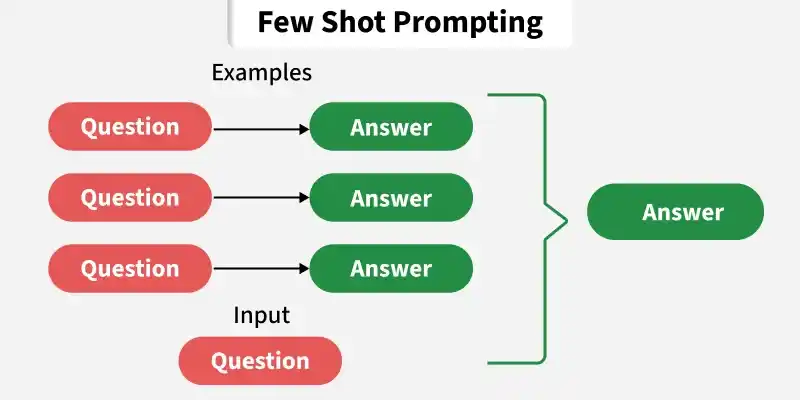
Few-shot prompting là một kỹ thuật prompt trong đó người dùng cung cấp một vài ví dụ mẫu (few shots) trong prompt để hướng dẫn mô hình AI hiểu được định dạng, phong cách, hoặc logic mà bạn mong muốn trước khi đưa ra yêu cầu thực tế.


(Nguồn: https://media.geeksforgeeks.org/wp-content/uploads/20260323104641179017/few_shot_prompting.webp )


Ví dụ cụ thể:

Phân loại cảm xúc của câu sau:


Câu: "Món này ngon quá!"  (Tích cực)

Câu: "Dịch vụ tệ, không bao giờ quay lại."  (Tiêu cực)

Câu: "Giao hàng đúng hẹn."  (Trung lập)

Hãy phân loại:  "Nhân viên rất thân thiện và nhiệt tình." 

Các trường hợp có thể xảy ra

  • Zero-shot: không có ví dụ nào, chỉ hỏi thẳng.
  • One-shot: cho 1 ví dụ.
  • Few-shot: cho 2–5 ví dụ.

Ở đây, 3 ví dụ đầu là các "shot" giúp mô hình hiểu rõ cách phân loại, và câu cuối là yêu cầu thực tế. 


(Nguồn: https://www.linkedin.com/posts/uppala-aravind-28-lin_ai-machinelearning-promptengineering-activity-7359848185281835008-Ky_E)


Nguồn tài liệu tham khảo và đọc thêm

  • https://www.ibm.com/think/topics/few-shot-prompting
  • https://www.datacamp.com/tutorial/few-shot-prompting


Thứ Ba, 6 tháng 10, 2026

Kitagawa decomposition

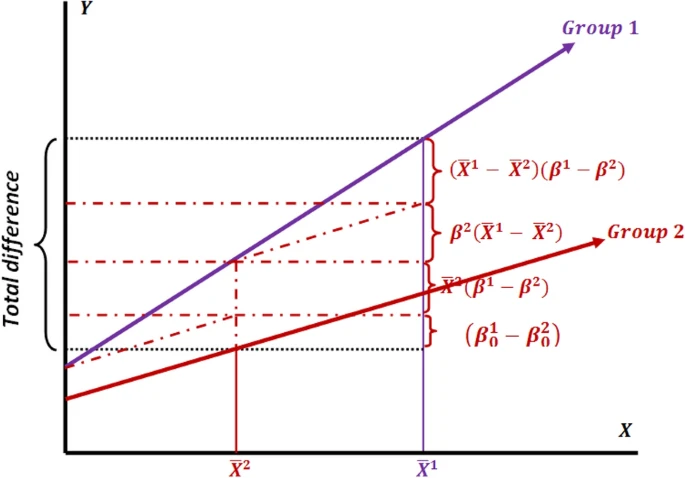
Phân rã Kitagawa bắt nguồn từ công trình “Components of a Difference between Two Rates” do Evelyn M. Kitagawa công bố năm 1955 trên Journal of the American Statistical Association. Kế thừa phương pháp chuẩn hóa trong dân số học, bà tách chênh lệch tỷ lệ giữa hai quần thể thành phần do khác biệt cơ cấu và phần do khác biệt tỷ lệ trong từng nhóm. Phương pháp ban đầu không dựa trên hồi quy.


(Nguồn: https://link.springer.com/article/10.1186/s12982-021-00100-9)


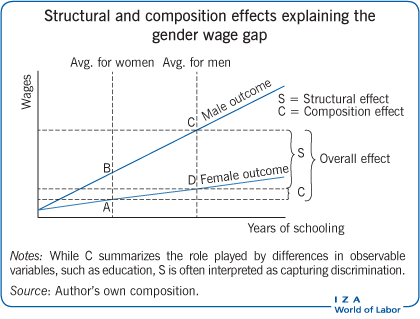
Năm 1973, Alan Blinder và Ronald Oaxaca công bố các phương pháp phân rã chênh lệch tiền lương dựa trên hồi quy tuyến tính, về sau được gọi là phân rã Oaxaca–Blinder. Nghiên cứu của Oaxaca–Blinder không trích dẫn Kitagawa.


(Nguồn: https://wol.iza.org/articles/identifying-and-measuring-economic-discrimination/long )


Gần đây, đóng góp của Kitagawa được chú ý hơn trong kinh tế học, cùng sự xuất hiện của tên gọi “Kitagawa–Oaxaca–Blinder”.


Tài liệu đọc thêm và tham khảo

  •  https://pmc.ncbi.nlm.nih.gov/articles/PMC12074319/
  • https://pure.rug.nl/ws/files/10068144/thesis.pdf
  • https://link.springer.com/article/10.1186/s12982-021-00100-9

Chủ Nhật, 4 tháng 10, 2026

Chatbot Traits

Chatbot traits là các đặc điểm hoặc thuộc tính của chatbot, thể hiện qua cách chatbot giao tiếp, phản hồi và tương tác với người dùng.

Thay vì chỉ trả lời như một cỗ máy khô khan, các traits giúp chatbot định hình nhân cách (persona), quyết định cách nó phản hồi người dùng trong từng tình huống cụ thể. Ví dụ, khi lập trình hoặc viết prompt cho AI (System Prompt), người ta có định nghĩa các trait bằng quy tắc cụ thể trong câu prompt. 


(Nguồn: https://arxiv.org/html/2601.12727v1)


Các nhóm Chatbot Traits phổ biến

  • Phong cách giao tiếp (Communication Style) 
thể hiện qua cách chatbot sử dụng ngôn ngữ và biểu đạt trong quá trình tương tác với người dùng. Chatbot có thể giao tiếp theo phong cách trang trọng, sử dụng từ ngữ chuẩn mực và lịch sự, hoặc theo phong cách thân mật, gần gũi, có sử dụng từ lóng và từ viết tắt. Giọng điệu của chatbot cũng có thể nghiêm túc, tập trung trực tiếp vào vấn đề, hoặc hài hước, pha trò nhẹ nhàng để tạo cảm giác thoải mái. Bên cạnh đó, chatbot có thể thể hiện sự hào hứng thông qua các biểu đạt cảm xúc và dấu chấm than, hoặc duy trì cách phản hồi điềm tĩnh, trung tính và chú trọng thông tin. 


(Nguồn: https://www.prorealtech.com/why-every-business-needs-an-ai-chatbot-for-24-7-customer-support/)

  • Đặc điểm hành vi và thái độ (Behavioral Traits) 

thể hiện qua cách chatbot phản hồi nhu cầu, cảm xúc và những khó khăn của người dùng. Tính thấu cảm được thể hiện qua việc ghi nhận cảm xúc, đưa ra lời xin lỗi hoặc phản hồi mang tính chia sẻ khi người dùng gặp sự cố. Tính kiên nhẫn thể hiện ở việc chatbot duy trì thái độ lịch sự, sẵn sàng giải thích lại khi người dùng hỏi nhiều lần hoặc trình bày chưa rõ. Tính chủ động thể hiện qua việc chatbot gợi ý thêm thông tin hữu ích hoặc đề xuất bước tiếp theo bên cạnh việc trả lời câu hỏi được đặt ra.

  • Vai trò định hình (Persona Role) 

là hình tượng mà chatbot được thiết kế để thể hiện trong quá trình tương tác.Với vai trò chuyên gia, chatbot hướng đến cách phản hồi chính xác, thể hiện kiến thức chuyên sâu và tạo cảm nhận đáng tin cậy, phù hợp với các bối cảnh như ngân hàng, y tế và pháp lý. Với vai trò trợ lý thân thiện, chatbot chú trọng sự chu đáo, lịch sự và dễ tiếp cận, thường được sử dụng trong dịch vụ khách hàng và thương mại điện tử. Với vai trò người đồng hành, chatbot có thể sử dụng cách giao tiếp hài hước, sáng tạo và giàu biểu đạt cảm xúc nhằm tạo sự gắn kết với người dùng trong các ứng dụng giải trí, trò chơi và học ngoại ngữ.

Nguồn tài liệu tham khảo và đọc thêm

  • https://www.linkedin.com/pulse/introduction-chatbots-damian-calitz-zshgf
  • https://arxiv.org/html/2601.12727v1

Thứ Sáu, 2 tháng 10, 2026

AI overreliance

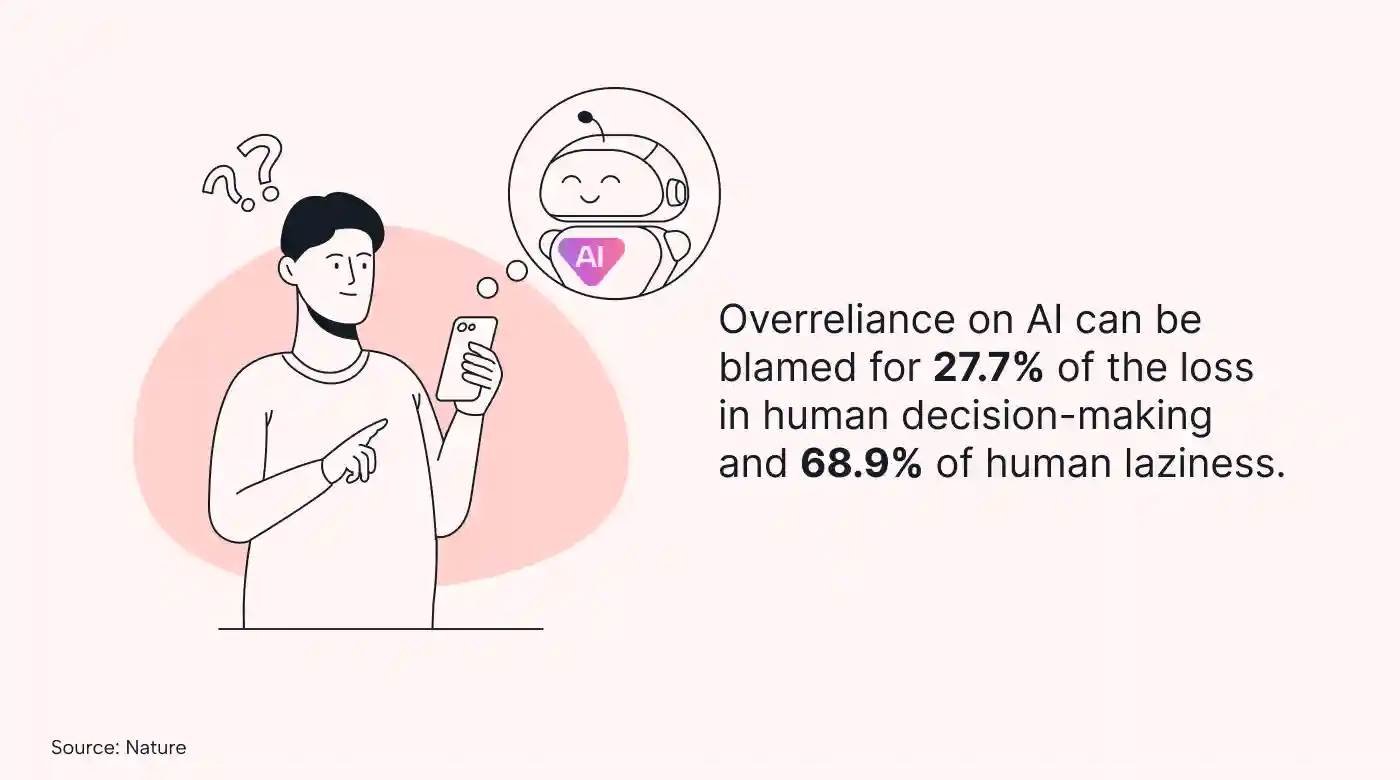
 AI overreliance là sự phụ thuộc quá mức vào trí tuệ nhân tạo, xảy ra khi người dùng tin tưởng hoặc làm theo kết quả do AI đưa ra mà thiếu kiểm tra, đánh giá và phán đoán độc lập, kể cả khi AI có thể sai hoặc không phù hợp với tình huống.


(Nguồn: https://www.theguardian.com/us-news/2026/jun/19/chatbots-critical-thinking-skills )


Ví dụ trong học tập và nghiên cứu:

  • Sinh viên dùng nguyên câu trả lời của ChatGPT mà không hiểu hoặc kiểm chứng nội dung.
  • Người nghiên cứu trích dẫn tài liệu do AI đề xuất mà không kiểm tra tài liệu có tồn tại hay không.
  • Người phân tích chấp nhận cách chọn mô hình của AI mà không xem xét giả định và đặc điểm dữ liệu.
  • Người dùng thay đổi đáp án đúng của mình theo một gợi ý sai từ AI.
  • ...


(Nguồn: https://www.usemotion.com/blog/ai-timeline-generator )


Một người dùng AI phải kiểm chứng và tự chịu trách nhiệm về quyết định của mình, không nên phụ thuộc quá mức vào AI.

Tài liệu đọc thêm và tham khảo

  • https://hai.stanford.edu/news/ai-overreliance-problem-are-explanations-solution
  • https://www.linkedin.com/posts/nir-zicherman-172a461a_heres-what-ai-is-doing-to-your-brain-every-activity-7465126581741506560-6M6C 
  • https://www.theguardian.com/us-news/2026/jun/19/chatbots-critical-thinking-skills

Thứ Tư, 30 tháng 9, 2026

Agentic marketing

Agentic marketing là việc sử dụng các AI agent có khả năng chủ động thực hiện hoạt động marketing để đạt một mục tiêu được xác định trước. 


(Nguồn: https://www.xenonstack.com/blog/agentic-ai-marketing-campaigns )

Khác với AI tạo sinh chỉ phản hồi từng yêu cầu hoặc marketing automation vận hành theo quy tắc cố định, AI agent có thể:

  • phân tích khách hàng và thị trường;
  • lập kế hoạch chiến dịch;
  • tạo và cá nhân hóa nội dung;
  • lựa chọn kênh truyền thông;
  • theo dõi kết quả;
  • tự điều chỉnh hoạt động dựa trên dữ liệu mới.


Ví dụ, khi được giao mục tiêu tăng số người đăng ký một chương trình đào tạo, AI agent có thể phân nhóm đối tượng, xây dựng thông điệp riêng, triển khai chiến dịch trên nhiều kênh và tối ưu nội dung theo tỷ lệ chuyển đổi.

Nói ngắn gọn, agentic marketing không chỉ dùng AI để tạo nội dung mà còn để chủ động phối hợp và tối ưu hóa toàn bộ quá trình marketing.


(Nguồn: https://www.tatvic.com/blog/agentic-ai-for-marketing-driving-results-with-intelligent-automation/)


Tài liệu tham khảo và đọc thêm

  • https://www.docket.io/blog/agentic-marketing 
  •  https://emarsys.com/learn/blog/what-is-agentic-marketing/
  • https://voyado.com/resources/blog/agentic-ai-for-marketing/

Thứ Hai, 28 tháng 9, 2026

Quantum emulator

Quantum emulator—trình giả lập lượng tử—là một chương trình chạy trên máy tính cổ điển như CPU, GPU hoặc siêu máy tính, dùng để mô phỏng hoạt động của máy tính lượng tử. 


(Nguồn: https://itbrief.co.uk/story/qleo-quantum-emulator-gains-gpu-boost-full-cuda-q-support)

Có thể xem Quantum emulator là một “máy tính lượng tử ảo” chạy bên trong máy tính thông thường. Nó không sử dụng qubit vật lý và cũng không trực tiếp khai thác các hiện tượng lượng tử. Thay vào đó, phần mềm dùng toán học để tính toán trạng thái lượng tử mà một máy tính lượng tử thật sẽ tạo ra.

Quantum emulator dùng để làm gì?

  • Phát triển và kiểm tra thuật toán

Lập trình viên có thể thử nghiệm mạch lượng tử trước khi chạy trên phần cứng thật. Emulator giúp:

    • kiểm tra thuật toán;
    • phát hiện lỗi trong mã;
    • quan sát trạng thái trung gian;
    • thử nhiều cấu hình qubit và cổng;
    • so sánh kết quả mong đợi với kết quả thực tế.

  • Giảng dạy và học tập

Người học có thể thực hành:

    • superposition—chồng chập;
    • entanglement—vướng víu;
    • quantum gates—cổng lượng tử;
    • quantum measurement—phép đo lượng tử;
    • các thuật toán như Grover hoặc Shor ở quy mô nhỏ.

mà không cần sở hữu hoặc truy cập một máy tính lượng tử vật lý.


(Nguồn: https://www.researchgate.net/publication/340848388_Modifying_quantum_Grover's_algorithm_for_dynamic_multi-pattern_search_on_reconfigurable_hardware )


Tài liệu tham khảo và đọc thêm

  • https://quantummotion.com/glossary-terms/quantum-emulator/
  • https://www.fz-juelich.de/en/research/research-fields/information/quantum-technology/quantum-emulators

Thứ Bảy, 26 tháng 9, 2026

Analog and digital quantum simulation

Mô phỏng lượng tử (quantum simulation) là việc sử dụng một hệ lượng tử có thể kiểm soát để nghiên cứu hành vi của một hệ lượng tử khác—chẳng hạn phân tử, vật liệu, nam châm lượng tử hoặc phản ứng hóa học. Có hai cách tiếp cận chính: analog quantum simulation và digital quantum simulation.


(Nguồn: https://www.researchgate.net/figure/Analog-versus-digital-computing-on-the-different-quantum-and-neuromorphic-platforms_fig1_342520394)


Analog quantum simulator

Thiết bị được thiết kế để bắt chước trực tiếp một hệ vật lý cụ thể. Hệ tiến hóa liên tục dưới một Hamiltonian được kiểm soát. 

Ưu điểm:

  • yêu cầu chất lượng qubit có thể thấp hơn;
  • không cần phân rã toàn bộ quá trình thành hàng nghìn cổng;
  • phù hợp với một số bài toán vật lý nhiều hạt.

Hạn chế:

  • ít linh hoạt;
  • thường chuyên biệt cho một nhóm bài toán;
  • khó kiểm chứng kết quả ở quy mô mà máy cổ điển không còn mô phỏng được.


(Nguồn: https://www.researchgate.net/publication/382827280_Going_beyond_gadgets_the_importance_of_scalability_for_analogue_quantum_simulators )


Digital quantum simulation

Sử dụng chuỗi cổng lượng tử để mô phỏng quá trình tiến hóa. Thay vì tạo ra một hệ vật lý tương tự, nhà khoa học biểu diễn trạng thái của hệ bằng qubit, chuyển Hamiltonian thành một chuỗi phép toán lượng tử, thực hiện các cổng lượng tử theo trình tự, đo kết quả. Và lặp lại nhiều lần để ước lượng các đại lượng cần quan tâm.

Cách tiếp cận này gần giống mô phỏng số trên máy tính thông thường: một quá trình liên tục được chia thành nhiều bước nhỏ. Điểm khác biệt là các bước được thực hiện bằng cổng lượng tử trên qubit.

Ưu điểm:

  • có khả năng lập trình;
  • linh hoạt hơn;
  • về lý thuyết có thể mô phỏng nhiều loại hệ thống.

Hạn chế:

  • mỗi cổng lượng tử có thể tạo thêm sai số;
  • cần thiết bị ổn định;
  • những bài toán lớn có thể cần sửa lỗi lượng tử.

Người ta nhận định rằng mô phỏng analog có thể mang lại giá trị nghiên cứu sớm hơn, trong khi mô phỏng số có tiềm năng tổng quát hơn về dài hạn.

Tài liệu tham khảo và đọc thêm

  • https://www.quera.com/glossary/analog-quantum-computing
  • https://www.pasqal.com/technology/analog-and-digital-in-quantum-computing/
  • https://quantumcomputing.stackexchange.com/questions/40267/what-is-the-difference-between-digital-and-analog-quantum-computing
  • https://www.ryanlarose.com/uploads/1/1/5/8/115879647/analogueqs_part1.pdf

Thứ Năm, 24 tháng 9, 2026

Quantum simulation

Bài viết “Quantum Simulation Explained: The Next Big Thing in Advanced Computing” của The Quantum Insider giới thiệu mô phỏng lượng tử theo góc nhìn vừa kỹ thuật vừa kinh doanh. Luận điểm chính là: mô phỏng lượng tử có thể trở thành một trong những ứng dụng thực tế sớm nhất của điện toán lượng tử, đặc biệt trong nghiên cứu thuốc và vật liệu.


(Nguồn: https://quantumzeitgeist.com/quantum-simulation-efficiency-gains-with-compressed-entangled-states-for-materials/)


Quantum simulation được hiểu như thế nào?

Bài viết sử dụng thuật ngữ quantum simulation cho hai cách tiếp cận khác nhau:

  • Mô phỏng hệ lượng tử bằng máy tính cổ điển

CPU, GPU hoặc siêu máy tính sử dụng các phương trình, thuật toán số và AI để mô phỏng hành vi của nguyên tử, electron và phân tử. Đây là phương pháp đang được sử dụng phổ biến. Tuy nhiên, khi số lượng hạt và tương tác tăng lên, khối lượng tính toán có thể trở nên quá lớn.

  • Mô phỏng bằng máy tính lượng tử

Máy tính lượng tử sử dụng qubit và các hiện tượng lượng tử để mô hình hóa một hệ vật lý lượng tử. Vì bản thân thiết bị cũng hoạt động theo cơ học lượng tử, nó được kỳ vọng có thể biểu diễn một số tương tác tự nhiên hiệu quả hơn máy tính cổ điển.

Ở cấp độ phân tử, vật chất được chi phối bởi các tương tác giữa electron và hạt nhân. Để mô phỏng chính xác một hệ như vậy, máy tính phải mô tả rất nhiều trạng thái có thể xảy ra đồng thời. Khi số hạt tăng, độ phức tạp tính toán thường tăng rất nhanh. Các siêu máy tính vì thế phải thu nhỏ mô hình; bỏ qua một số tương tác; sử dụng các giả định; hoặc áp dụng phương pháp xấp xỉ.

Máy tính lượng tử được quan tâm vì qubit có thể biểu diễn trạng thái chồng chập và vướng víu. Về lý thuyết, điều này khiến nó phù hợp tự nhiên với việc mô phỏng các hệ lượng tử. Tuy nhiên, “phù hợp tự nhiên” không có nghĩa là máy tính lượng tử hiện nay đã có thể mô phỏng chính xác mọi phân tử. Phần cứng vẫn phải đủ lớn, ổn định và ít lỗi.


(Nguồn: https://www.amd.com/en/developer/resources/technical-articles/2025/fast-track-quantum-simulation-with-xanadu-s-pennylane-lightning-.html)


Vai trò của AI trong quantum simulation

Bài viết cho thấy quantum simulation không nhất thiết là một quy trình hoàn toàn lượng tử. Trong thực tế, nhiều hệ thống sẽ kết hợp máy tính cổ điển; điện toán hiệu năng cao; trí tuệ nhân tạo; học máy; và máy tính lượng tử.


AI có thể hỗ trợ bằng cách:

  • Sàng lọc một số lượng rất lớn phân tử hoặc vật liệu.
  • Xác định những ứng viên đáng nghiên cứu nhất.
  • Xây dựng mô hình xấp xỉ từ dữ liệu mô phỏng.
  • Tối ưu hóa tham số của thuật toán lượng tử.
  • Phân tích kết quả do thiết bị lượng tử tạo ra.


Máy tính lượng tử chỉ cần giải quyết phần đặc biệt khó, còn các bước khác được thực hiện trên máy tính cổ điển. Đây được gọi là hybrid quantum–classical computing.


Một số ứng dụng:

  •  Ứng dụng trong phát triển thuốc

Bài viết đặc biệt nhấn mạnh drug discovery vì phát triển một loại thuốc mới thường tốn nhiều năm và chi phí rất lớn. Mô phỏng được sử dụng để nghiên cứu:

    • cấu trúc của phân tử;
    • vị trí phân tử thuốc có thể gắn vào protein;
    • khả năng gắn và tách khỏi mục tiêu sinh học;
    • ảnh hưởng của đột biến đến tương tác giữa thuốc và protein;
    • cách điều chỉnh cấu trúc phân tử để tăng hiệu quả và giảm tác dụng phụ.

Quantum simulation được kỳ vọng giúp cải thiện khâu mô phỏng, qua đó giảm số lượng hợp chất phải tổng hợp và thử nghiệm thực tế.


  • Ứng dụng trong khoa học vật liệu

Một nội dung quan trọng khác là Density Functional Theory – DFT, thường dịch là lý thuyết phiếm hàm mật độ. DFT là phương pháp tính toán dùng để ước lượng cấu trúc điện tử và năng lượng của nguyên tử, phân tử hoặc vật liệu. Thay vì theo dõi trực tiếp hàm sóng cực kỳ phức tạp của tất cả electron, DFT tập trung vào mật độ electron. Từ kết quả đó, nhà khoa học có thể dự đoán:

    • độ dẫn điện;
    • độ bền và ổn định;
    • khả năng phản ứng hóa học;
    • tính chất quang học;
    • tính chất nhiệt động lực học;
    • khả năng lưu trữ hoặc chuyển đổi năng lượng.

Ứng dụng tiềm năng gồm thiết kế  pin hiệu suất cao; pin mặt trời;  chất xúc tác xanh; vật liệu bán dẫn; vật liệu nhẹ và bền; hoặc vật liệu có độ dẫn điện đặc biệt. Máy tính lượng tử được kỳ vọng cải thiện việc tính toán những cấu trúc điện tử có tương quan mạnh, nơi các phương pháp cổ điển thông thường có thể kém chính xác hoặc tốn nhiều tài nguyên.


Tài liệu tham khảo và đọc thêm

  • https://thequantuminsider.com/2024/07/25/quantum-simulation-explained-the-next-big-thing-in-advanced-computing/
  • https://www.quera.com/glossary/quantum-simulator
  • https://mphq.physics.harvard.edu/quantum-simulation

Thứ Ba, 22 tháng 9, 2026

AI–quantum “frenemies”

Bài viết “AI and quantum computers will be frenemies” của The Economist đăng ngày 29 tháng 7 năm 2026 cho rằng trí tuệ nhân tạo (AI) và máy tính lượng tử sẽ vừa là đối tác, vừa là đối thủ — vì thế được gọi là “frenemies” (friends + enemies).


(Nguồn: https://setcoin.group/article/quantum-ai-convergence)


AI và máy tính lượng tử có những thế mạnh khác nhau

AI rất giỏi nhận diện mẫu, học từ dữ liệu và dự đoán. Máy tính lượng tử được kỳ vọng giải quyết một số bài toán chuyên biệt mà máy tính cổ điển rất khó xử lý, đặc biệt là mô phỏng các hệ lượng tử trong hóa học, vật liệu và sinh học. Máy tính lượng tử không phải là phiên bản nhanh hơn của máy tính thông thường và cũng không thay thế AI trong mọi nhiệm vụ.


Vì vậy, hai công nghệ có thể hỗ trợ lẫn nhau. 

  • AI có thể thúc đẩy sự phát triển của máy tính lượng tử bằng cách:

    • thiết kế vật liệu và linh kiện lượng tử;
    • điều khiển, hiệu chỉnh các qubit;
    • phát hiện và sửa lỗi lượng tử;
    • hỗ trợ viết và tối ưu hóa thuật toán lượng tử;
    • xác định những bài toán phù hợp để đưa sang máy tính lượng tử.

  • Ở chiều ngược lại, máy tính lượng tử có thể hỗ trợ AI bằng cách:

    • thực hiện một số phép tính tối ưu hóa hoặc lấy mẫu phức tạp;
    • tạo ra dữ liệu mô phỏng khoa học có độ chính xác cao để huấn luyện AI;
    • hỗ trợ những mô hình học máy chuyên biệt như quantum reservoir computing;
    • mở rộng khả năng khám phá thuốc, vật liệu mới, pin và các quá trình hóa học.


(Nguồn: https://startupfortune.com/a-quantum-ai-test-on-ibm-hardware-points-to-a-new-compute-race/)


Nhưng AI và lượng tử cũng cạnh tranh

Hai lĩnh vực đang cạnh tranh về:

  • vốn đầu tư;
  • nhân lực khoa học và kỹ thuật trình độ cao;
  • sự quan tâm của chính phủ và doanh nghiệp;
  • cơ sở hạ tầng tính toán;
  • vị trí trung tâm trong chiến lược công nghệ của các tập đoàn lớn.

AI đã tạo ra sản phẩm và doanh thu thực tế, trong khi lợi ích thương mại của máy tính lượng tử vẫn còn chưa chắc chắn. Vì vậy, làn sóng đầu tư vào AI có thể hút nguồn lực khỏi lĩnh vực lượng tử. Mặt khác, nhu cầu điện và hạ tầng khổng lồ của các trung tâm dữ liệu AI cũng khiến người ta quan tâm hơn đến những kiến trúc tính toán chuyên dụng và tiết kiệm tài nguyên.

Tương lai của sự kết hợp AI–quantum 

Kịch bản hợp lý nhất không phải là máy tính lượng tử thay thế AI hoặc thay thế máy tính cổ điển. Tương lai có nhiều khả năng thuộc về những hệ thống tính toán lai.

Trong hệ thống đó:

  • máy tính cổ điển đảm nhiệm phần lớn các tác vụ thông thường;
  • AI phân tích dữ liệu, dự đoán và điều phối quy trình;
  • bộ xử lý lượng tử chỉ xử lý những phần bài toán mà nó thực sự có lợi thế.

Người sử dụng thậm chí có thể không nhận ra lúc nào máy tính lượng tử được huy động. Tương tự việc các ứng dụng hiện nay tự động phân phối công việc giữa CPU, GPU và dịch vụ đám mây, các hệ thống tương lai có thể gửi một phần bài toán đến bộ xử lý lượng tử rồi đưa kết quả trở lại quy trình AI.

Điểm quan trọng là không phải bài toán nào cũng cần máy tính lượng tử. Thành công sẽ không thuộc về tổ chức sử dụng công nghệ phức tạp nhất, mà thuộc về tổ chức xác định đúng bài toán và kết hợp đúng công cụ.

Tài liệu tham khảo và đọc thêm

  • https://www.economist.com/science-and-technology/2026/07/29/ai-and-quantum-computers-will-be-frenemies
  • https://www.linkedin.com/posts/mikelutheromaha_artificialintelligence-quantumcomputing-activity-7501814156141056001-h1Uy
  • https://www.linkedin.com/posts/scottgraffius_ai-artificialintelligence-quantumcomputing-activity-7498652642483662848-8Y_b 

Chủ Nhật, 20 tháng 9, 2026

Fibonacci Spirals in Plants

Xoắn ốc Fibonacci ở thực vật là hiện tượng các cơ quan mọc quanh một trục — hạt hướng dương, vảy quả thông, mắt dứa, cánh hoa, lá trên thân — tự sắp xếp thành những đường xoắn mà số lượng đường xoắn hầu như luôn là số Fibonacci: 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89…

Cơ chế nằm ở góc phân kỳ (divergence angle) — góc lệch giữa hai mầm mọc liên tiếp. Khi góc này bằng góc vàng ≈ 137,507° (tức 360° ÷ φ², với φ là tỉ lệ vàng ≈ 1,618), các mầm không bao giờ xếp chồng lên nhau thành tia thẳng, và mắt ta tự động nhận ra các đường xoắn với số lượng là số Fibonacci.


(nguồn: https://www.newmarkettoday.ca/local-news/gardening-each-leaf-petal-spiral-shows-perfection-of-natures-design-9218650)


(nguồn: https://www.vmcdn.ca/f/files/midlandtoday/images/gardening/fib-grid.jpeg;w=960)


Về nguyên nhân sinh học, đây là hệ quả của cơ chế hóa sinh. Mỗi mầm mới hình thành ở đỉnh sinh trưởng đều hút cạn hormone auxin xung quanh nó, tạo ra một "vùng cấm". Mầm tiếp theo buộc phải xuất hiện ở chỗ xa các mầm cũ nhất, tức là ở khoảng trống rộng nhất. Lặp lại quy tắc đơn giản này qua nhiều lượt, hệ thống tự hội tụ về góc vàng. Các nhà nghiên cứu Douady và Couder năm 1992 đã tái tạo đúng hiện tượng này bằng thí nghiệm nhỏ giọt dầu từ tính trên đĩa dầu silicon — không có gen, không có thực vật, mà vẫn ra xoắn ốc Fibonacci.


(Nguồn: https://sarevneed.amebaownd.com/posts/53466846/ )


Tài liệu tham khảo và đọc thêm

  •  https://samratseniitmadras.wixsite.com/websam/post/the-fibonacci-sequence-in-nature
  • https://www.newmarkettoday.ca/local-news/gardening-each-leaf-petal-spiral-shows-perfection-of-natures-design-9218650
  • https://www.civilsdaily.com/news/fibonacci-spirals-in-plants-and-fossil-discoveries/

Thứ Sáu, 18 tháng 9, 2026

Phyllotaxy

 Phyllotaxy (hay phyllotaxis) là cách sắp xếp lá trên thân hoặc cành của thực vật. Nói đơn giản, nó mô tả lá mọc ở đâu và theo quy luật nào quanh thân cây.


(Nguồn: https://www.flowerspicture.org/nerium_oleander.html)

Các kiểu phyllotaxy phổ biến gồm:


  • Alternate (so le): mỗi đốt chỉ có một lá, các lá mọc xen kẽ nhau. Ví dụ: xoài, dâm bụt
  • Opposite (đối): mỗi đốt có hai lá mọc đối diện nhau. Ví dụ: ổi, bạc hà.
  • Whorled (mọc vòng): mỗi đốt có từ ba lá trở lên mọc thành vòng quanh thân. Ví dụ: trúc đào.

  • Spiral (mọc xoắn ốc): lá xếp theo đường xoắn quanh thân, mỗi lá lệch so với lá trước một góc gần cố định khoảng 137,5° (gọi là góc vàng). Con số này liên quan trực tiếp đến dãy Fibonacci, và cũng chính là cơ chế tạo ra các đường xoắn ta thấy ở đài hoa hướng dương, vảy quả thông hay quả dứa.

(Nguồn: https://www.slideshare.net/slideshow/phylotaxis/250026478 )


Ý nghĩa sinh học của phyllotaxy nằm ở chỗ nó giúp cây giảm tối đa việc lá che khuất nhau, nhờ đó mỗi lá nhận được nhiều ánh sáng nhất có thể để quang hợp. Trong phân loại học, kiểu mọc lá cũng là một đặc điểm quan trọng để nhận dạng loài.


(Nguồn: https://geometrymatters.com/decoding-the-mathematical-secrets-of-plants-spiraling-leaf-patterns/)


Tài liệu tham khảo và đọc thêm

  • https://mgnv.org/plants/glossary/glossary-phyllotaxis-alternate-opposite/
  • https://crosbyholmegrown.uk/resources/description-classification-botany/botany/botany-four-phyllotaxy-leaves/
  • https://geometrymatters.com/decoding-the-mathematical-secrets-of-plants-spiraling-leaf-patterns/

Blue carbon

Blue carbon ( carbon xanh lam ) là lượng carbon được hấp thụ và lưu trữ bởi các hệ sinh thái biển và ven biển. Ba hệ sinh thái chính là: Rừn...