Thứ Bảy, 10 tháng 10, 2026

Knowledge Distillation

Knowledge Distillation (chưng cất tri thức) là kỹ thuật huấn luyện một mô hình nhỏ, gọi là mô hình học sinh (student), học theo đầu ra hoặc biểu diễn của một mô hình mạnh hơn, gọi là mô hình giáo viên (teacher).
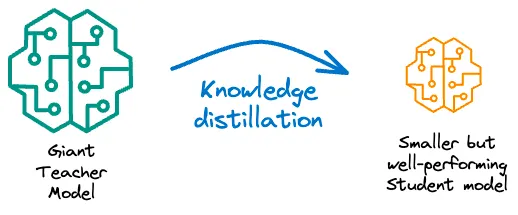

(Nguồn: https://blog.dailydoseofds.com/p/implement-knowledge-distillation)

Mục tiêu là giúp mô hình nhỏ giữ được nhiều năng lực của mô hình lớn, đồng thời giảm chi phí tính toán, dung lượng lưu trữ và thời gian phản hồi. Kỹ thuật này được giới thiệu bởi Geoffrey Hinton và cộng sự trong bài báo "Distilling the Knowledge in a Neural Network" (2015) và hiện được sử dụng rộng rãi trong NLP, computer vision, và cả việc huấn luyện các mô hình ngôn ngữ lớn (LLM).

(Nguồn: https://huggingface.co/blog/Kseniase/kd )

Ví dụ, người dùng muốn xây dựng mô hình phân loại phản hồi của sinh viên. Quá trình có thể diễn ra như sau:

Bước 1: Cho mô hình lớn đọc và phân loại nhiều phản hồi. 

Kết quả từ mô hình lớn

“Thầy giảng dễ hiểu, ví dụ rất thực tế.” Tích cực

“Em chưa hiểu cách làm bài tập.”                 Tiêu cực

“Buổi học bắt đầu lúc 18 giờ.”                 Trung tính


Bước 2: Dùng các cặp phản hồi–kết quả này để huấn luyện mô hình nhỏ. Qua nhiều ví dụ, mô hình nhỏ học những cách diễn đạt thường gắn với từng loại cảm xúc. Nếu tiếp cận được xác suất dự đoán của mô hình lớn, nó còn có thể học mức độ chắc chắn giữa các lựa chọn.

Bước 3: Cho mô hình nhỏ tự xử lý phản hồi mới. Chẳng hạn, khi gặp câu “Các ví dụ giúp em hiểu bài hơn”, mô hình nhỏ có thể phân loại là tích cực, mà không cần hỏi lại mô hình lớn. 


Lợi ích chính là dùng mô hình lớn để huấn luyện, rồi dùng mô hình nhỏ để phục vụ người dùng với chi phí thấp hơn. Mô hình nhỏ có thể làm tốt nhiệm vụ được dạy, nhưng không tự động có toàn bộ năng lực của mô hình lớn và vẫn có thể học theo các lỗi của nó. Khác với việc đưa vài ví dụ vào prompt, quá trình này thực sự huấn luyện và thay đổi trọng số của mô hình nhỏ.

(Nguồn: https://blog.roboflow.com/what-is-knowledge-distillation/)

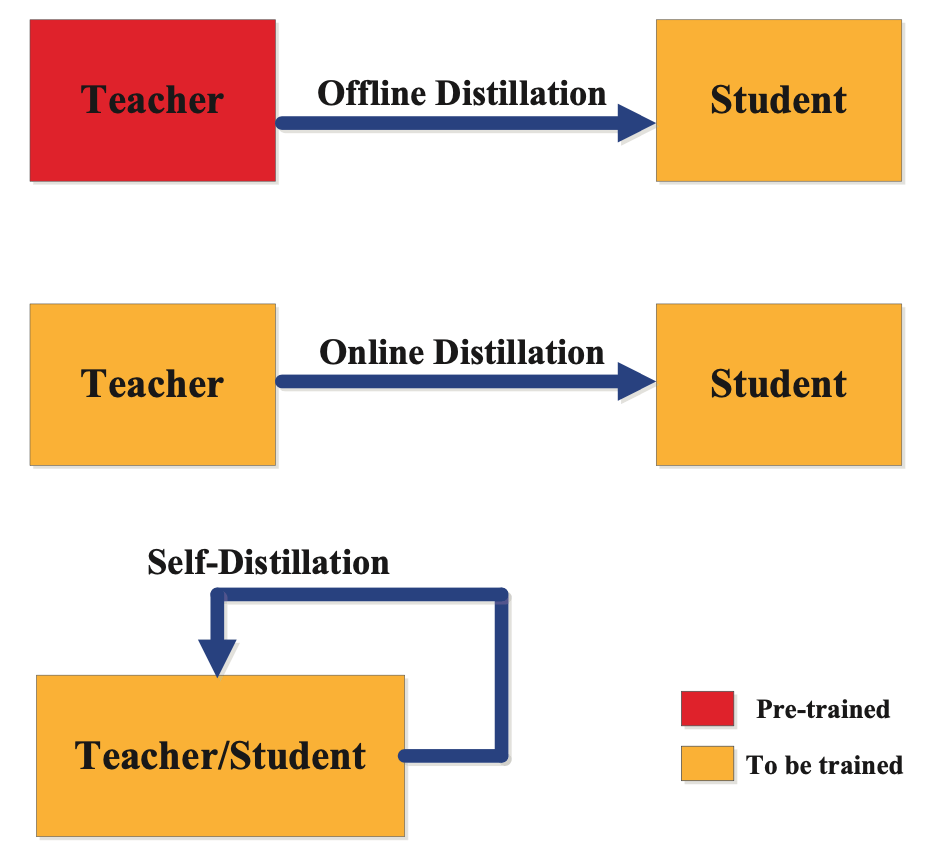
Ba phương pháp Knowledge Distillation


  •  Chưng cất tri thức ngoại tuyến (Offline Distillation)
Trong phương pháp này, mô hình giáo viên được huấn luyện trước, sau đó giữ cố định các tham số. Khi huấn luyện mô hình học sinh, giáo viên cung cấp đầu ra hoặc các biểu diễn trung gian để học sinh học theo, nhưng bản thân giáo viên không được cập nhật.

Có thể hình dung đây là cách “giáo viên đã học xong, sau đó hướng dẫn học sinh”. Nhiều nghiên cứu tập trung cải thiện cách truyền tri thức, chẳng hạn lựa chọn thông tin nào từ giáo viên và thiết kế hàm mất mát để học sinh tiếp thu hiệu quả. Ưu điểm là tận dụng được một mô hình giáo viên đã hoạt động tốt; tuy nhiên, hiệu quả còn phụ thuộc vào mức độ phù hợp giữa giáo viên, học sinh và nhiệm vụ.
  •  Chưng cất tri thức trực tuyến (Online Distillation)
Trong phương pháp này, các mô hình được huấn luyện đồng thời và truyền tri thức cho nhau trong quá trình học. Thay vì luôn dựa vào một giáo viên đã huấn luyện hoàn chỉnh, tín hiệu hướng dẫn có thể đến từ một mô hình đang học, từ nhiều mô hình cùng học hoặc từ kết quả kết hợp của chúng.

Có thể hình dung đây là cách “vừa học, vừa hướng dẫn nhau”. Trong một số thiết kế, các mô hình học hỏi lẫn nhau thông qua dự đoán, giúp mỗi mô hình cải thiện kết quả. Tuy nhiên, cơ chế phản hồi hai chiều không phải yêu cầu bắt buộc của mọi phương pháp. Ví dụ nghiên cứu về huấn luyện đồng thời và học hỏi giữa các mô hình.

Từ “trực tuyến” ở đây đề cập đến việc truyền tri thức ngay trong quá trình huấn luyện. Nó không nhất thiết có nghĩa là sử dụng Internet, tiếp nhận dữ liệu thời gian thực hoặc học liên tục từ dữ liệu mới. Khả năng thích nghi với dữ liệu thay đổi cần được thiết kế và đánh giá riêng.
  •  Tự chưng cất tri thức (Self-Distillation)
Tự chưng cất sử dụng tri thức từ chính mô hình hoặc một phiên bản của mô hình để hướng dẫn việc học, thay vì nhất thiết cần một giáo viên riêng biệt có quy mô lớn hơn. Có thể hình dung đây là cách “mô hình học từ chính mình để cải thiện”.

Trong cách triển khai được mô tả ở đoạn gốc, các bộ phân loại phụ được gắn vào những tầng trung gian của mạng. Phần sâu hơn đóng vai trò giáo viên, hướng dẫn phần nông hơn. Quá trình huấn luyện kết hợp việc giảm khác biệt giữa các dự đoán và giảm khoảng cách giữa các biểu diễn đặc trưng, chẳng hạn bằng hàm mất mát L2. Khi sử dụng mô hình để dự đoán, có thể loại bỏ các nhánh phụ nếu chỉ cần đầu ra cuối cùng. Đây là một hướng tự chưng cất trong cùng mạng.


Tài liệu tham khảo và đọc thêm

  • https://www.ibm.com/think/topics/knowledge-distillation
  • https://huggingface.co/blog/Kseniase/kd
  • https://blog.roboflow.com/what-is-knowledge-distillation/
Thứ Năm, 8 tháng 10, 2026

Few-shot Prompting

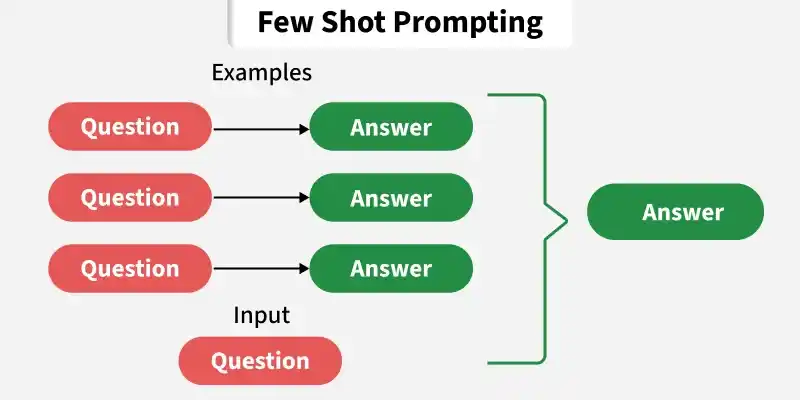
Few-shot prompting là một kỹ thuật prompt trong đó người dùng cung cấp một vài ví dụ mẫu (few shots) trong prompt để hướng dẫn mô hình AI hiểu được định dạng, phong cách, hoặc logic mà bạn mong muốn trước khi đưa ra yêu cầu thực tế.


(Nguồn: https://media.geeksforgeeks.org/wp-content/uploads/20260323104641179017/few_shot_prompting.webp )


Ví dụ cụ thể:

Phân loại cảm xúc của câu sau:


Câu: "Món này ngon quá!"  (Tích cực)

Câu: "Dịch vụ tệ, không bao giờ quay lại."  (Tiêu cực)

Câu: "Giao hàng đúng hẹn."  (Trung lập)

Hãy phân loại:  "Nhân viên rất thân thiện và nhiệt tình." 

Các trường hợp có thể xảy ra

  • Zero-shot: không có ví dụ nào, chỉ hỏi thẳng.
  • One-shot: cho 1 ví dụ.
  • Few-shot: cho 2–5 ví dụ.

Ở đây, 3 ví dụ đầu là các "shot" giúp mô hình hiểu rõ cách phân loại, và câu cuối là yêu cầu thực tế. 


(Nguồn: https://www.linkedin.com/posts/uppala-aravind-28-lin_ai-machinelearning-promptengineering-activity-7359848185281835008-Ky_E)


Nguồn tài liệu tham khảo và đọc thêm

  • https://www.ibm.com/think/topics/few-shot-prompting
  • https://www.datacamp.com/tutorial/few-shot-prompting


Thứ Ba, 6 tháng 10, 2026

Kitagawa decomposition

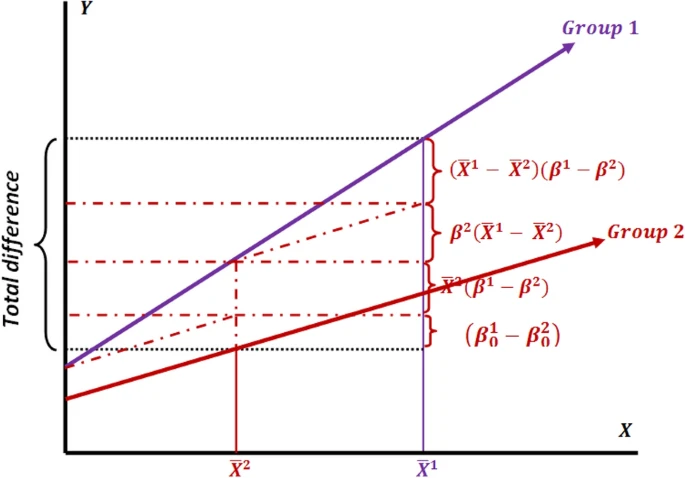
Phân rã Kitagawa bắt nguồn từ công trình “Components of a Difference between Two Rates” do Evelyn M. Kitagawa công bố năm 1955 trên Journal of the American Statistical Association. Kế thừa phương pháp chuẩn hóa trong dân số học, bà tách chênh lệch tỷ lệ giữa hai quần thể thành phần do khác biệt cơ cấu và phần do khác biệt tỷ lệ trong từng nhóm. Phương pháp ban đầu không dựa trên hồi quy.


(Nguồn: https://link.springer.com/article/10.1186/s12982-021-00100-9)


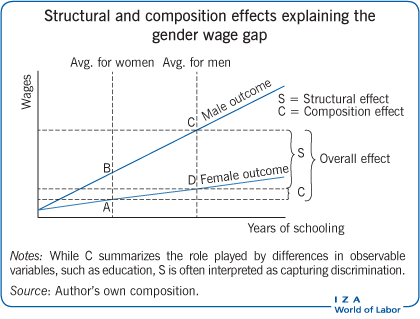
Năm 1973, Alan Blinder và Ronald Oaxaca công bố các phương pháp phân rã chênh lệch tiền lương dựa trên hồi quy tuyến tính, về sau được gọi là phân rã Oaxaca–Blinder. Nghiên cứu của Oaxaca–Blinder không trích dẫn Kitagawa.


(Nguồn: https://wol.iza.org/articles/identifying-and-measuring-economic-discrimination/long )


Gần đây, đóng góp của Kitagawa được chú ý hơn trong kinh tế học, cùng sự xuất hiện của tên gọi “Kitagawa–Oaxaca–Blinder”.


Tài liệu đọc thêm và tham khảo

  •  https://pmc.ncbi.nlm.nih.gov/articles/PMC12074319/
  • https://pure.rug.nl/ws/files/10068144/thesis.pdf
  • https://link.springer.com/article/10.1186/s12982-021-00100-9

Chủ Nhật, 4 tháng 10, 2026

Chatbot Traits

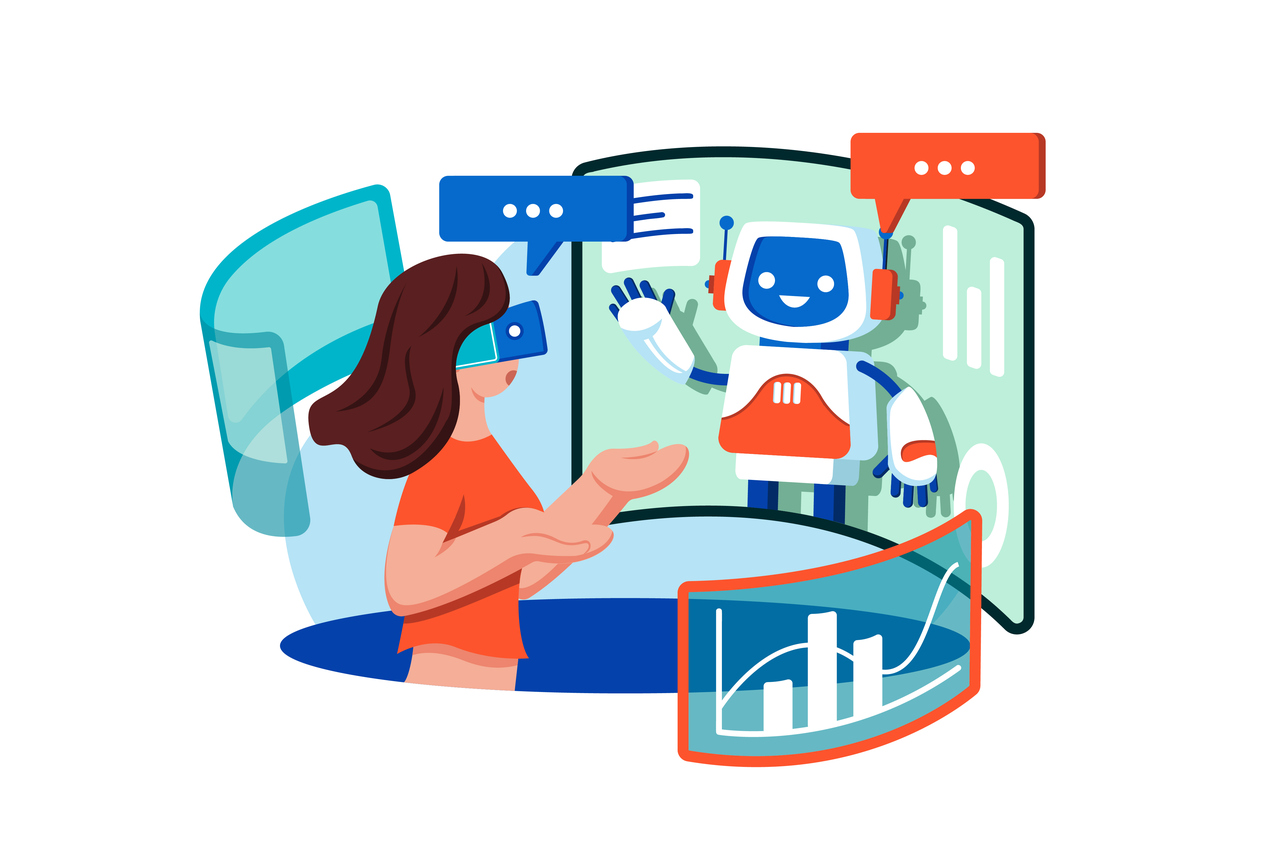
Chatbot traits là các đặc điểm hoặc thuộc tính của chatbot, thể hiện qua cách chatbot giao tiếp, phản hồi và tương tác với người dùng.

Thay vì chỉ trả lời như một cỗ máy khô khan, các traits giúp chatbot định hình nhân cách (persona), quyết định cách nó phản hồi người dùng trong từng tình huống cụ thể. Ví dụ, khi lập trình hoặc viết prompt cho AI (System Prompt), người ta có định nghĩa các trait bằng quy tắc cụ thể trong câu prompt. 


(Nguồn: https://arxiv.org/html/2601.12727v1)


Các nhóm Chatbot Traits phổ biến

  • Phong cách giao tiếp (Communication Style) 
thể hiện qua cách chatbot sử dụng ngôn ngữ và biểu đạt trong quá trình tương tác với người dùng. Chatbot có thể giao tiếp theo phong cách trang trọng, sử dụng từ ngữ chuẩn mực và lịch sự, hoặc theo phong cách thân mật, gần gũi, có sử dụng từ lóng và từ viết tắt. Giọng điệu của chatbot cũng có thể nghiêm túc, tập trung trực tiếp vào vấn đề, hoặc hài hước, pha trò nhẹ nhàng để tạo cảm giác thoải mái. Bên cạnh đó, chatbot có thể thể hiện sự hào hứng thông qua các biểu đạt cảm xúc và dấu chấm than, hoặc duy trì cách phản hồi điềm tĩnh, trung tính và chú trọng thông tin. 


(Nguồn: https://www.prorealtech.com/why-every-business-needs-an-ai-chatbot-for-24-7-customer-support/)

  • Đặc điểm hành vi và thái độ (Behavioral Traits) 

thể hiện qua cách chatbot phản hồi nhu cầu, cảm xúc và những khó khăn của người dùng. Tính thấu cảm được thể hiện qua việc ghi nhận cảm xúc, đưa ra lời xin lỗi hoặc phản hồi mang tính chia sẻ khi người dùng gặp sự cố. Tính kiên nhẫn thể hiện ở việc chatbot duy trì thái độ lịch sự, sẵn sàng giải thích lại khi người dùng hỏi nhiều lần hoặc trình bày chưa rõ. Tính chủ động thể hiện qua việc chatbot gợi ý thêm thông tin hữu ích hoặc đề xuất bước tiếp theo bên cạnh việc trả lời câu hỏi được đặt ra.

  • Vai trò định hình (Persona Role) 

là hình tượng mà chatbot được thiết kế để thể hiện trong quá trình tương tác.Với vai trò chuyên gia, chatbot hướng đến cách phản hồi chính xác, thể hiện kiến thức chuyên sâu và tạo cảm nhận đáng tin cậy, phù hợp với các bối cảnh như ngân hàng, y tế và pháp lý. Với vai trò trợ lý thân thiện, chatbot chú trọng sự chu đáo, lịch sự và dễ tiếp cận, thường được sử dụng trong dịch vụ khách hàng và thương mại điện tử. Với vai trò người đồng hành, chatbot có thể sử dụng cách giao tiếp hài hước, sáng tạo và giàu biểu đạt cảm xúc nhằm tạo sự gắn kết với người dùng trong các ứng dụng giải trí, trò chơi và học ngoại ngữ.

Nguồn tài liệu tham khảo và đọc thêm

  • https://www.linkedin.com/pulse/introduction-chatbots-damian-calitz-zshgf
  • https://arxiv.org/html/2601.12727v1

Thứ Sáu, 2 tháng 10, 2026

AI overreliance

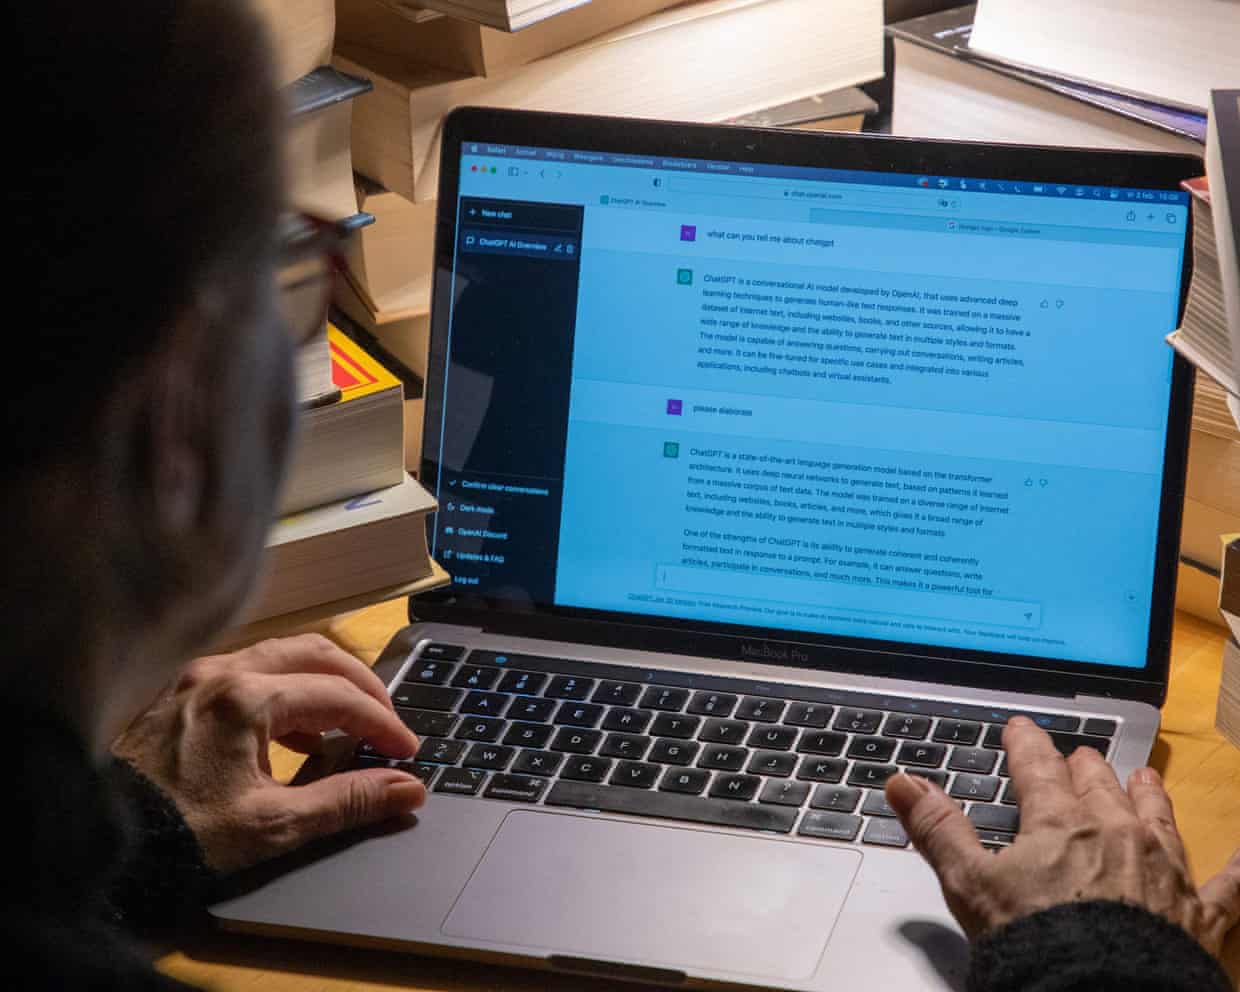
 AI overreliance là sự phụ thuộc quá mức vào trí tuệ nhân tạo, xảy ra khi người dùng tin tưởng hoặc làm theo kết quả do AI đưa ra mà thiếu kiểm tra, đánh giá và phán đoán độc lập, kể cả khi AI có thể sai hoặc không phù hợp với tình huống.


(Nguồn: https://www.theguardian.com/us-news/2026/jun/19/chatbots-critical-thinking-skills )


Ví dụ trong học tập và nghiên cứu:

  • Sinh viên dùng nguyên câu trả lời của ChatGPT mà không hiểu hoặc kiểm chứng nội dung.
  • Người nghiên cứu trích dẫn tài liệu do AI đề xuất mà không kiểm tra tài liệu có tồn tại hay không.
  • Người phân tích chấp nhận cách chọn mô hình của AI mà không xem xét giả định và đặc điểm dữ liệu.
  • Người dùng thay đổi đáp án đúng của mình theo một gợi ý sai từ AI.
  • ...


(Nguồn: https://www.usemotion.com/blog/ai-timeline-generator )


Một người dùng AI phải kiểm chứng và tự chịu trách nhiệm về quyết định của mình, không nên phụ thuộc quá mức vào AI.

Tài liệu đọc thêm và tham khảo

  • https://hai.stanford.edu/news/ai-overreliance-problem-are-explanations-solution
  • https://www.linkedin.com/posts/nir-zicherman-172a461a_heres-what-ai-is-doing-to-your-brain-every-activity-7465126581741506560-6M6C 
  • https://www.theguardian.com/us-news/2026/jun/19/chatbots-critical-thinking-skills

Thứ Tư, 30 tháng 9, 2026

Agentic marketing

Agentic marketing là việc sử dụng các AI agent có khả năng chủ động thực hiện hoạt động marketing để đạt một mục tiêu được xác định trước. 


(Nguồn: https://www.xenonstack.com/blog/agentic-ai-marketing-campaigns )

Khác với AI tạo sinh chỉ phản hồi từng yêu cầu hoặc marketing automation vận hành theo quy tắc cố định, AI agent có thể:

  • phân tích khách hàng và thị trường;
  • lập kế hoạch chiến dịch;
  • tạo và cá nhân hóa nội dung;
  • lựa chọn kênh truyền thông;
  • theo dõi kết quả;
  • tự điều chỉnh hoạt động dựa trên dữ liệu mới.


Ví dụ, khi được giao mục tiêu tăng số người đăng ký một chương trình đào tạo, AI agent có thể phân nhóm đối tượng, xây dựng thông điệp riêng, triển khai chiến dịch trên nhiều kênh và tối ưu nội dung theo tỷ lệ chuyển đổi.

Nói ngắn gọn, agentic marketing không chỉ dùng AI để tạo nội dung mà còn để chủ động phối hợp và tối ưu hóa toàn bộ quá trình marketing.


(Nguồn: https://www.tatvic.com/blog/agentic-ai-for-marketing-driving-results-with-intelligent-automation/)


Tài liệu tham khảo và đọc thêm

  • https://www.docket.io/blog/agentic-marketing 
  •  https://emarsys.com/learn/blog/what-is-agentic-marketing/
  • https://voyado.com/resources/blog/agentic-ai-for-marketing/

Thứ Hai, 28 tháng 9, 2026

Quantum emulator

Quantum emulator—trình giả lập lượng tử—là một chương trình chạy trên máy tính cổ điển như CPU, GPU hoặc siêu máy tính, dùng để mô phỏng hoạt động của máy tính lượng tử. 


(Nguồn: https://itbrief.co.uk/story/qleo-quantum-emulator-gains-gpu-boost-full-cuda-q-support)

Có thể xem Quantum emulator là một “máy tính lượng tử ảo” chạy bên trong máy tính thông thường. Nó không sử dụng qubit vật lý và cũng không trực tiếp khai thác các hiện tượng lượng tử. Thay vào đó, phần mềm dùng toán học để tính toán trạng thái lượng tử mà một máy tính lượng tử thật sẽ tạo ra.

Quantum emulator dùng để làm gì?

  • Phát triển và kiểm tra thuật toán

Lập trình viên có thể thử nghiệm mạch lượng tử trước khi chạy trên phần cứng thật. Emulator giúp:

    • kiểm tra thuật toán;
    • phát hiện lỗi trong mã;
    • quan sát trạng thái trung gian;
    • thử nhiều cấu hình qubit và cổng;
    • so sánh kết quả mong đợi với kết quả thực tế.

  • Giảng dạy và học tập

Người học có thể thực hành:

    • superposition—chồng chập;
    • entanglement—vướng víu;
    • quantum gates—cổng lượng tử;
    • quantum measurement—phép đo lượng tử;
    • các thuật toán như Grover hoặc Shor ở quy mô nhỏ.

mà không cần sở hữu hoặc truy cập một máy tính lượng tử vật lý.


(Nguồn: https://www.researchgate.net/publication/340848388_Modifying_quantum_Grover's_algorithm_for_dynamic_multi-pattern_search_on_reconfigurable_hardware )


Tài liệu tham khảo và đọc thêm

  • https://quantummotion.com/glossary-terms/quantum-emulator/
  • https://www.fz-juelich.de/en/research/research-fields/information/quantum-technology/quantum-emulators

Knowledge Distillation

Knowledge Distillation (chưng cất tri thức ) là kỹ thuật huấn luyện một mô hình nhỏ, gọi là mô hình học sinh (student), học theo đầu ra hoặc...