Hiển thị các bài đăng có nhãn Nghiên cứu. Hiển thị tất cả bài đăng

Thứ Năm, 15 tháng 5, 2025

Double-Blind Studies in Research

Double-blind study (nghiên cứu mù đôi) là một thiết kế nghiên cứu trong đó cả người tham gia lẫn người thực hiện nghiên cứu đều không biết ai thuộc nhóm kiểm soát và ai thuộc nhóm điều trị. 

Nghĩa là, trong một nghiên cứu mù đôi:

  • Người tham gia không biết mình đang nhận "thuốc thật" hay "giả dược" (placebo).
  • Người quản lý thí nghiệm hoặc bác sĩ điều trị cũng không biết người nào đang nhận cái gì.

Mục tiêu của phương pháp này là tránh các thiên lệch (bias) vô thức trong quá trình thực hiện và đánh giá nghiên cứu.
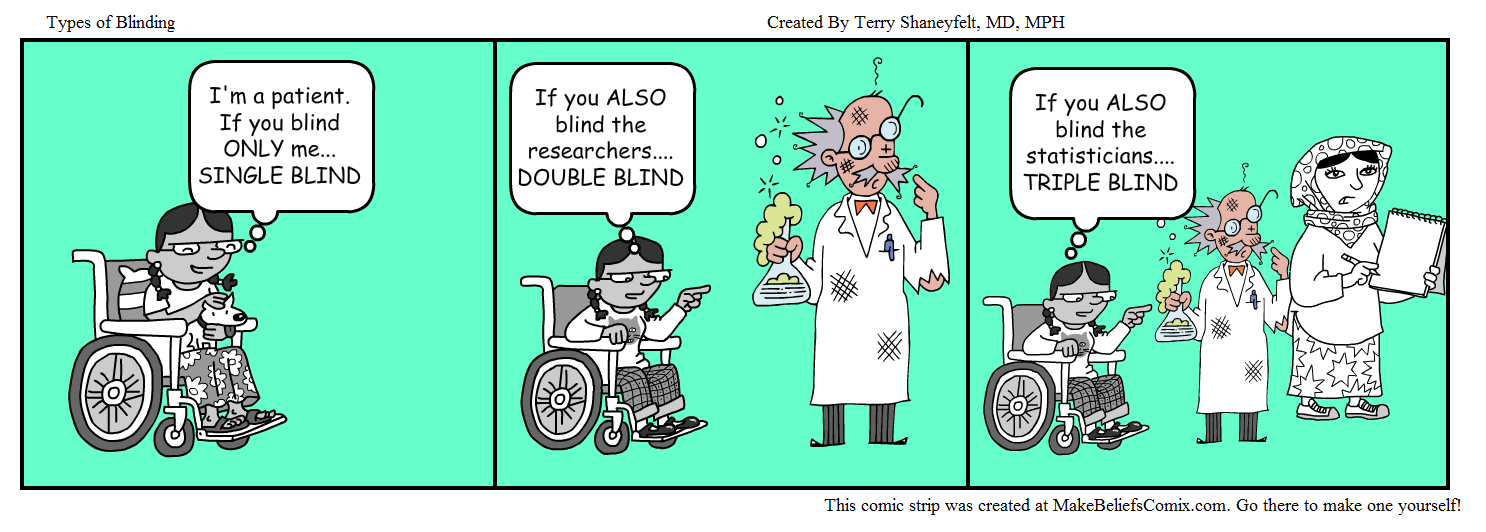


(Nguồn: https://ebmteacher.com/2016/06/21/a-cartoon-about-blinding-using-new-tools-can-be-fun/)


Tại sao cần Double-Blind Studies?

Trong nghiên cứu, nhất là nghiên cứu y học, tâm lý học và khoa học xã hội, thiên lệch (bias) là một vấn đề rất lớn. Một số loại thiên lệch có thể xảy ra:

  • Placebo effect, là khi người tham gia cảm thấy tốt hơn chỉ vì họ nghĩ rằng họ đang nhận điều trị hiệu quả, dù thực ra không có thuốc thật.
  • Experimenter bias, xảy ra khi người thực hiện nghiên cứu có thể vô tình ảnh hưởng tới người tham gia thông qua cử chỉ, thái độ, lời nói.
  • Expectation bias, xảy ra khi người tham gia có thể thay đổi hành vi nếu biết mình ở nhóm điều trị hay nhóm giả dược.

Double-blind giúp giảm tối đa những thiên lệch này, từ đó đảm bảo rằng kết quả nghiên cứu phản ánh tác động thực sự của can thiệp, không phải do kỳ vọng hay cảm nhận chủ quan. 

Double-Blind Study khác với Single-Blind Study thế nào?

  • Single-blind study: Người tham gia không biết mình thuộc nhóm nào, nhưng người nghiên cứu thì biết.
  • Double-blind study: Cả hai bên đều không biết nhóm nào.

(Nguồn: https://www.psychologytoday.com/ca/blog/finding-a-new-home/202004/treatments-for-covid-19-and-random-assignment)


Double-blind mạnh hơn vì nó kiểm soát được thiên lệch từ cả người tham gia và người nghiên cứu. Từ đó, giúp tăng độ tin cậy của kết quả nghiên cứu, giúp đánh giá tác động thực sự của một can thiệp hoặc liệu pháp.

Một số lĩnh vực ứng dụng

  • Y học: Thử nghiệm thuốc, vắc-xin, phương pháp điều trị mới.

  • Tâm lý học: Nghiên cứu tác động của liệu pháp tâm lý.

  • Giáo dục: Đánh giá hiệu quả chương trình đào tạo.

  • Kinh tế học hành vi: Thử nghiệm phản ứng tiêu dùng với sản phẩm/dịch vụ.

Tài liệu tham khảo

  • https://www.verywellmind.com/what-is-a-double-blind-study-2795103
  • https://www.ncbi.nlm.nih.gov/books/NBK546641/
  • https://www.simplypsychology.org/double-blind-experimental-study-and-procedure-explained.html

Thứ Bảy, 3 tháng 2, 2024

Bankruptcy risk

Rủi ro phá sản (Bankruptcy risk) là khả năng một doanh nghiệp không thể trả nợ hoặc không thể tiếp tục hoạt động do tình trạng tài chính không ổn định. Những yếu tố gây ra rủi ro này có thể bao gồm:

  • Nợ vay quá cao so với khả năng chi trả của doanh nghiệp 
  • Lợi nhuận kém, lỗ lực kinh doanh không đạt được dự kiến, hoặc không thể cạnh tranh trong ngành 
  • Sự biến đổi đột ngột trong thị trường, sự thay đổi chính sách quản lý, thuế, hoặc thị trường tài chính 
  • Không thể quản lý rủi ro tài chính hoặc không có chiến lược dự phòng đối với những biến động không mong muốn
(Nguồn: https://fastercapital.com/content/Analyzing-Profitability-for-Bankruptcy-Risk.html)


Có nhiều mô hình thống kê và dự đoán được sử dụng để đo lường và dự đoán rủi ro phá sản trong tài chính doanh nghiệp. Dưới đây là một số mô hình phổ biến:
  • Mô hình Altman Z-Score: 
Được phát triển bởi Edward Altman vào những năm 1960, mô hình Z-Score sử dụng một số chỉ số tài chính như tỷ lệ nợ vay, lợi nhuận, vốn chủ sở hữu, thanh khoản để dự đoán rủi ro phá sản. Các công thức tính toán điểm Z-Score được áp dụng cho các công ty, và kết quả điểm số giúp xác định khả năng phá sản của doanh nghiệp.
  • Mô hình Springate Score:
Tương tự như mô hình Z-Score, mô hình Springate Score sử dụng các chỉ số tài chính như tỷ lệ nợ vay, lợi nhuận, và thanh khoản để dự đoán rủi ro phá sản. Mô hình này đo lường sức mạnh tài chính của một doanh nghiệp thông qua các chỉ số và công thức tính điểm số.
  • Mô hình Ohlson O-Score: 
Mô hình O-Score của Ohlson dựa trên các yếu tố như lợi nhuận gộp, dòng tiền từ hoạt động kinh doanh, tỷ lệ nợ vay, và giá trị thị trường của công ty để đo đạc rủi ro phá sản.
  • Mô hình Merton's Structural Model: 
Được phát triển bởi Robert C. Merton, mô hình này dựa trên lý thuyết tài chính và mô hình Black-Scholes để ước tính rủi ro phá sản dựa trên giá trị của tài sản và nợ của công ty.
  • Mô hình KMV Model: 
Một mô hình dự đoán rủi ro phá sản dựa trên mô hình cơ bản của Merton. Nó sử dụng thông tin thị trường để đánh giá nguy cơ phá sản và đưa ra dự đoán thông qua việc xác định xác suất phá sản trong tương lai.
  • Logistic Regression
Hồi quy logistic với biến phụ thuộc nhị phân là một mô hình kinh tế lượng được sử dụng phổ biến nhất trong đánh giá rủi ro phá sản. Odlson (1980) là người tiên phong ứng dụng hồi quy logistics có điều kiện vào nghiên cứu dự báo khả năng vỡ nợ.
  • Machine Learning: 
Nhiều mô hình dự đoán rủi ro phá sản sử dụng phương pháp học máy, bao gồm mô hình hồi quy logistic và các thuật toán máy học như Random Forests, Support Vector Machines, Neural Networks để dự đoán khả năng phá sản dựa trên dữ liệu tài chính và không tài chính.

Tài liệu tham khảo:

  •  https://www.investopedia.com/terms/b/bankruptcyrisk.asp#:~:text=Bankruptcy%20risk%2C%20or%20insolvency%20risk,inability%20to%20service%20its%20debt.
  • https://pubmed.ncbi.nlm.nih.gov/20937903/
  • https://www.sciencedirect.com/science/article/abs/pii/S0957417417307224

Thứ Ba, 30 tháng 1, 2024

Bankruptcy prediction models


(Nguồn: https://digikogu.taltech.ee)


  • Beaver (1966) is a first researcher who uses financial ratios evaluate the bankruptcy risk of firms.
  • Early research (Altman, 1968; Ohlson, 1980) also use financial ratio
  • Market-based information such as Merton (1974),  Hillegeist, Keating, Cram, & Lundstedt (2004)
  • Discrete-time hazard model : Shumway (2001) use both accounting and market variables
  • Wu, Gaunt, & Gray (2010) use three groups of variables: financial ratios, market variables, and firm characteristics
  • Machine learning methods : Artificial neural network (ANN), Support vector machine (SVM), General Regression Neural Network (GRNN), Decision Trees...


AI overreliance

 AI overreliance là sự phụ thuộc quá mức vào trí tuệ nhân tạo, xảy ra khi người dùng tin tưởng hoặc làm theo kết quả do AI đưa ra mà thiếu k...