Knowledge Distillation (chưng cất tri thức) là kỹ thuật huấn luyện một mô hình nhỏ, gọi là mô hình học sinh (student), học theo đầu ra hoặc biểu diễn của một mô hình mạnh hơn, gọi là mô hình giáo viên (teacher).
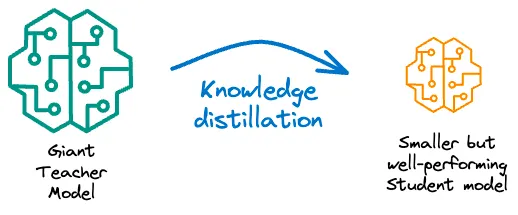
Mục tiêu là giúp mô hình nhỏ giữ được nhiều năng lực của mô hình lớn, đồng thời giảm chi phí tính toán, dung lượng lưu trữ và thời gian phản hồi. Kỹ thuật này được giới thiệu bởi Geoffrey Hinton và cộng sự trong bài báo "Distilling the Knowledge in a Neural Network" (2015) và hiện được sử dụng rộng rãi trong NLP, computer vision, và cả việc huấn luyện các mô hình ngôn ngữ lớn (LLM).

Ví dụ, người dùng muốn xây dựng mô hình phân loại phản hồi của sinh viên. Quá trình có thể diễn ra như sau:
Bước 1: Cho mô hình lớn đọc và phân loại nhiều phản hồi.
Kết quả từ mô hình lớn
“Thầy giảng dễ hiểu, ví dụ rất thực tế.” Tích cực
“Em chưa hiểu cách làm bài tập.” Tiêu cực
“Buổi học bắt đầu lúc 18 giờ.” Trung tính
Bước 2: Dùng các cặp phản hồi–kết quả này để huấn luyện mô hình nhỏ. Qua nhiều ví dụ, mô hình nhỏ học những cách diễn đạt thường gắn với từng loại cảm xúc. Nếu tiếp cận được xác suất dự đoán của mô hình lớn, nó còn có thể học mức độ chắc chắn giữa các lựa chọn.
Bước 3: Cho mô hình nhỏ tự xử lý phản hồi mới. Chẳng hạn, khi gặp câu “Các ví dụ giúp em hiểu bài hơn”, mô hình nhỏ có thể phân loại là tích cực, mà không cần hỏi lại mô hình lớn.
Lợi ích chính là dùng mô hình lớn để huấn luyện, rồi dùng mô hình nhỏ để phục vụ người dùng với chi phí thấp hơn. Mô hình nhỏ có thể làm tốt nhiệm vụ được dạy, nhưng không tự động có toàn bộ năng lực của mô hình lớn và vẫn có thể học theo các lỗi của nó. Khác với việc đưa vài ví dụ vào prompt, quá trình này thực sự huấn luyện và thay đổi trọng số của mô hình nhỏ.
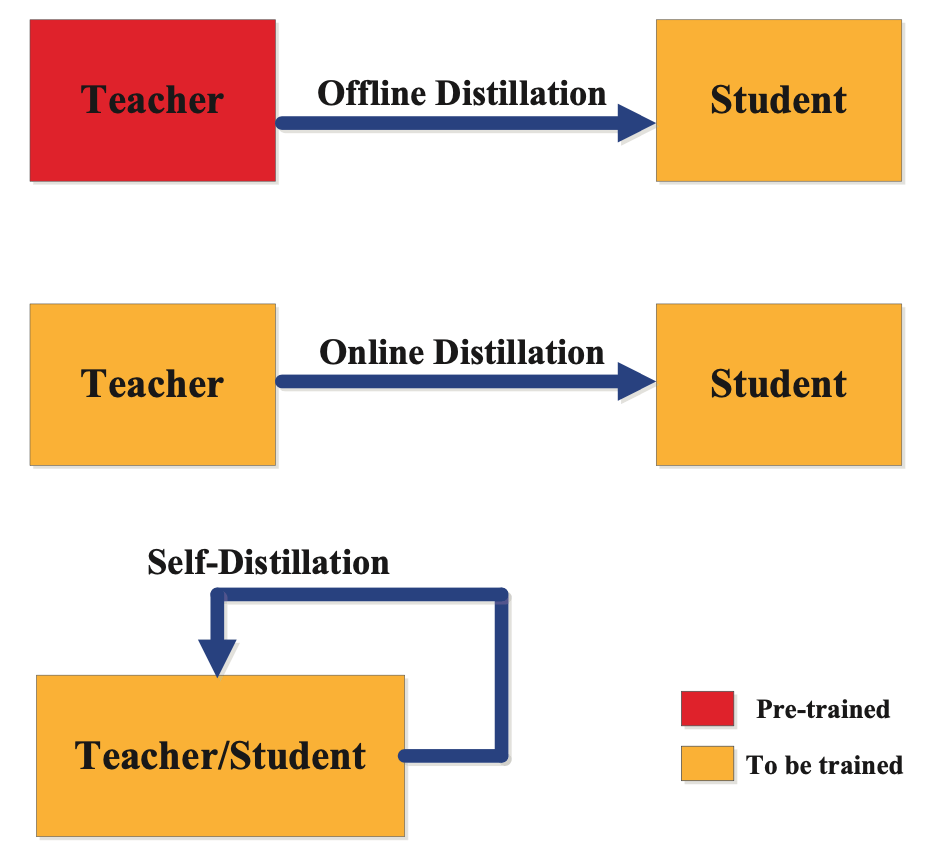
Ba phương pháp Knowledge Distillation
- Chưng cất tri thức ngoại tuyến (Offline Distillation)
Trong phương pháp này, mô hình giáo viên được huấn luyện trước, sau đó giữ cố định các tham số. Khi huấn luyện mô hình học sinh, giáo viên cung cấp đầu ra hoặc các biểu diễn trung gian để học sinh học theo, nhưng bản thân giáo viên không được cập nhật.Có thể hình dung đây là cách “giáo viên đã học xong, sau đó hướng dẫn học sinh”. Nhiều nghiên cứu tập trung cải thiện cách truyền tri thức, chẳng hạn lựa chọn thông tin nào từ giáo viên và thiết kế hàm mất mát để học sinh tiếp thu hiệu quả. Ưu điểm là tận dụng được một mô hình giáo viên đã hoạt động tốt; tuy nhiên, hiệu quả còn phụ thuộc vào mức độ phù hợp giữa giáo viên, học sinh và nhiệm vụ.
- Chưng cất tri thức trực tuyến (Online Distillation)
Trong phương pháp này, các mô hình được huấn luyện đồng thời và truyền tri thức cho nhau trong quá trình học. Thay vì luôn dựa vào một giáo viên đã huấn luyện hoàn chỉnh, tín hiệu hướng dẫn có thể đến từ một mô hình đang học, từ nhiều mô hình cùng học hoặc từ kết quả kết hợp của chúng.Có thể hình dung đây là cách “vừa học, vừa hướng dẫn nhau”. Trong một số thiết kế, các mô hình học hỏi lẫn nhau thông qua dự đoán, giúp mỗi mô hình cải thiện kết quả. Tuy nhiên, cơ chế phản hồi hai chiều không phải yêu cầu bắt buộc của mọi phương pháp. Ví dụ nghiên cứu về huấn luyện đồng thời và học hỏi giữa các mô hình.Từ “trực tuyến” ở đây đề cập đến việc truyền tri thức ngay trong quá trình huấn luyện. Nó không nhất thiết có nghĩa là sử dụng Internet, tiếp nhận dữ liệu thời gian thực hoặc học liên tục từ dữ liệu mới. Khả năng thích nghi với dữ liệu thay đổi cần được thiết kế và đánh giá riêng.
- Tự chưng cất tri thức (Self-Distillation)
Tự chưng cất sử dụng tri thức từ chính mô hình hoặc một phiên bản của mô hình để hướng dẫn việc học, thay vì nhất thiết cần một giáo viên riêng biệt có quy mô lớn hơn. Có thể hình dung đây là cách “mô hình học từ chính mình để cải thiện”.Trong cách triển khai được mô tả ở đoạn gốc, các bộ phân loại phụ được gắn vào những tầng trung gian của mạng. Phần sâu hơn đóng vai trò giáo viên, hướng dẫn phần nông hơn. Quá trình huấn luyện kết hợp việc giảm khác biệt giữa các dự đoán và giảm khoảng cách giữa các biểu diễn đặc trưng, chẳng hạn bằng hàm mất mát L2. Khi sử dụng mô hình để dự đoán, có thể loại bỏ các nhánh phụ nếu chỉ cần đầu ra cuối cùng. Đây là một hướng tự chưng cất trong cùng mạng.
Tài liệu tham khảo và đọc thêm
- https://www.ibm.com/think/topics/knowledge-distillation
- https://huggingface.co/blog/Kseniase/kd
- https://blog.roboflow.com/what-is-knowledge-distillation/


Không có nhận xét nào:
Đăng nhận xét